Naše webové stránky obsahujú odkazy na partnerské weby. Ak sa prekliknete z našich stránok na stránky partnera a tam si zakúpite jeho služby, obdržíme za sprostredkovanie províziu (Zistiť viac informácií). Táto forma spolupráce nijako neovplyvňuje objektívnosť našich recenzií. Každým nákupom cez kliknutie z našich stránok podporíte našu redakciu, aby sme aj do budúcnosti mohli tvoriť kvalitný a užitočný obsah. Ďakujeme.
Počítač na lokálnu AI v roku 2026: ako vybrať hardvér pre vlastné jazykové modely
Obsah
Chcete prevádzkovať jazykové modely u seba – bez predplatného, bez posielania dát do cloudu a pokojne aj offline? Potom neriešite procesor ani „TOPS“ na krabici, ale dve úplne iné veci: koľko pamäte môže model využiť a ako rýchlo ju počítač dokáže čítať. V tomto sprievodcovi vysvetľujeme, ako lokálna AI na počítači naozaj funguje, koľko pamäte potrebujú populárne modely a ako si v praxi vedú zariadenia, ktoré dnes kúpite na Alze – od grafickej karty za necelých 800 € po pracovnú stanicu pre celý tím. Pri každom nájdete overené čísla so zdrojmi a odporúčanie, pre koho sa hodí, pri vybraných aj krátke video.
Zhrnutie za 30 sekúnd
- Rozhoduje pamäť. Model musí celý ležať v rýchlej pamäti, ku ktorej má prístup grafika. V 4 bitoch počítajte zhruba 0,6 GB na miliardu parametrov.
- Rýchlosť písania určuje priepustnosť pamäte, rýchlosť čítania dlhého promptu výpočtový výkon. Preto Mac píše rýchlejšie ako DGX Spark, ale Spark rýchlejšie číta dlhé dokumenty.
- Najlepší pomer cena/výkon dnes: Mac Studio M5 Max so 128 GB (rýchle písanie), Ryzen AI Max+ 395 so 128 GB (najlacnejšia veľká pamäť), RTX 5060 Ti 16 GB (najlacnejší rozumný vstup).
- „AI PC“ s NPU nie je počítač na lokálnu AI. Ollama ani LM Studio NPU nepoužívajú.
Zariadenia sme sami netestovali – čísla preberáme z uvedených zdrojov a komunitné merania označujeme. Ceny platia k októbru 2026 a pre nedostatok pamätí sa tento rok menia takmer každý mesiac.
Čo kúpiť podľa rozpočtu
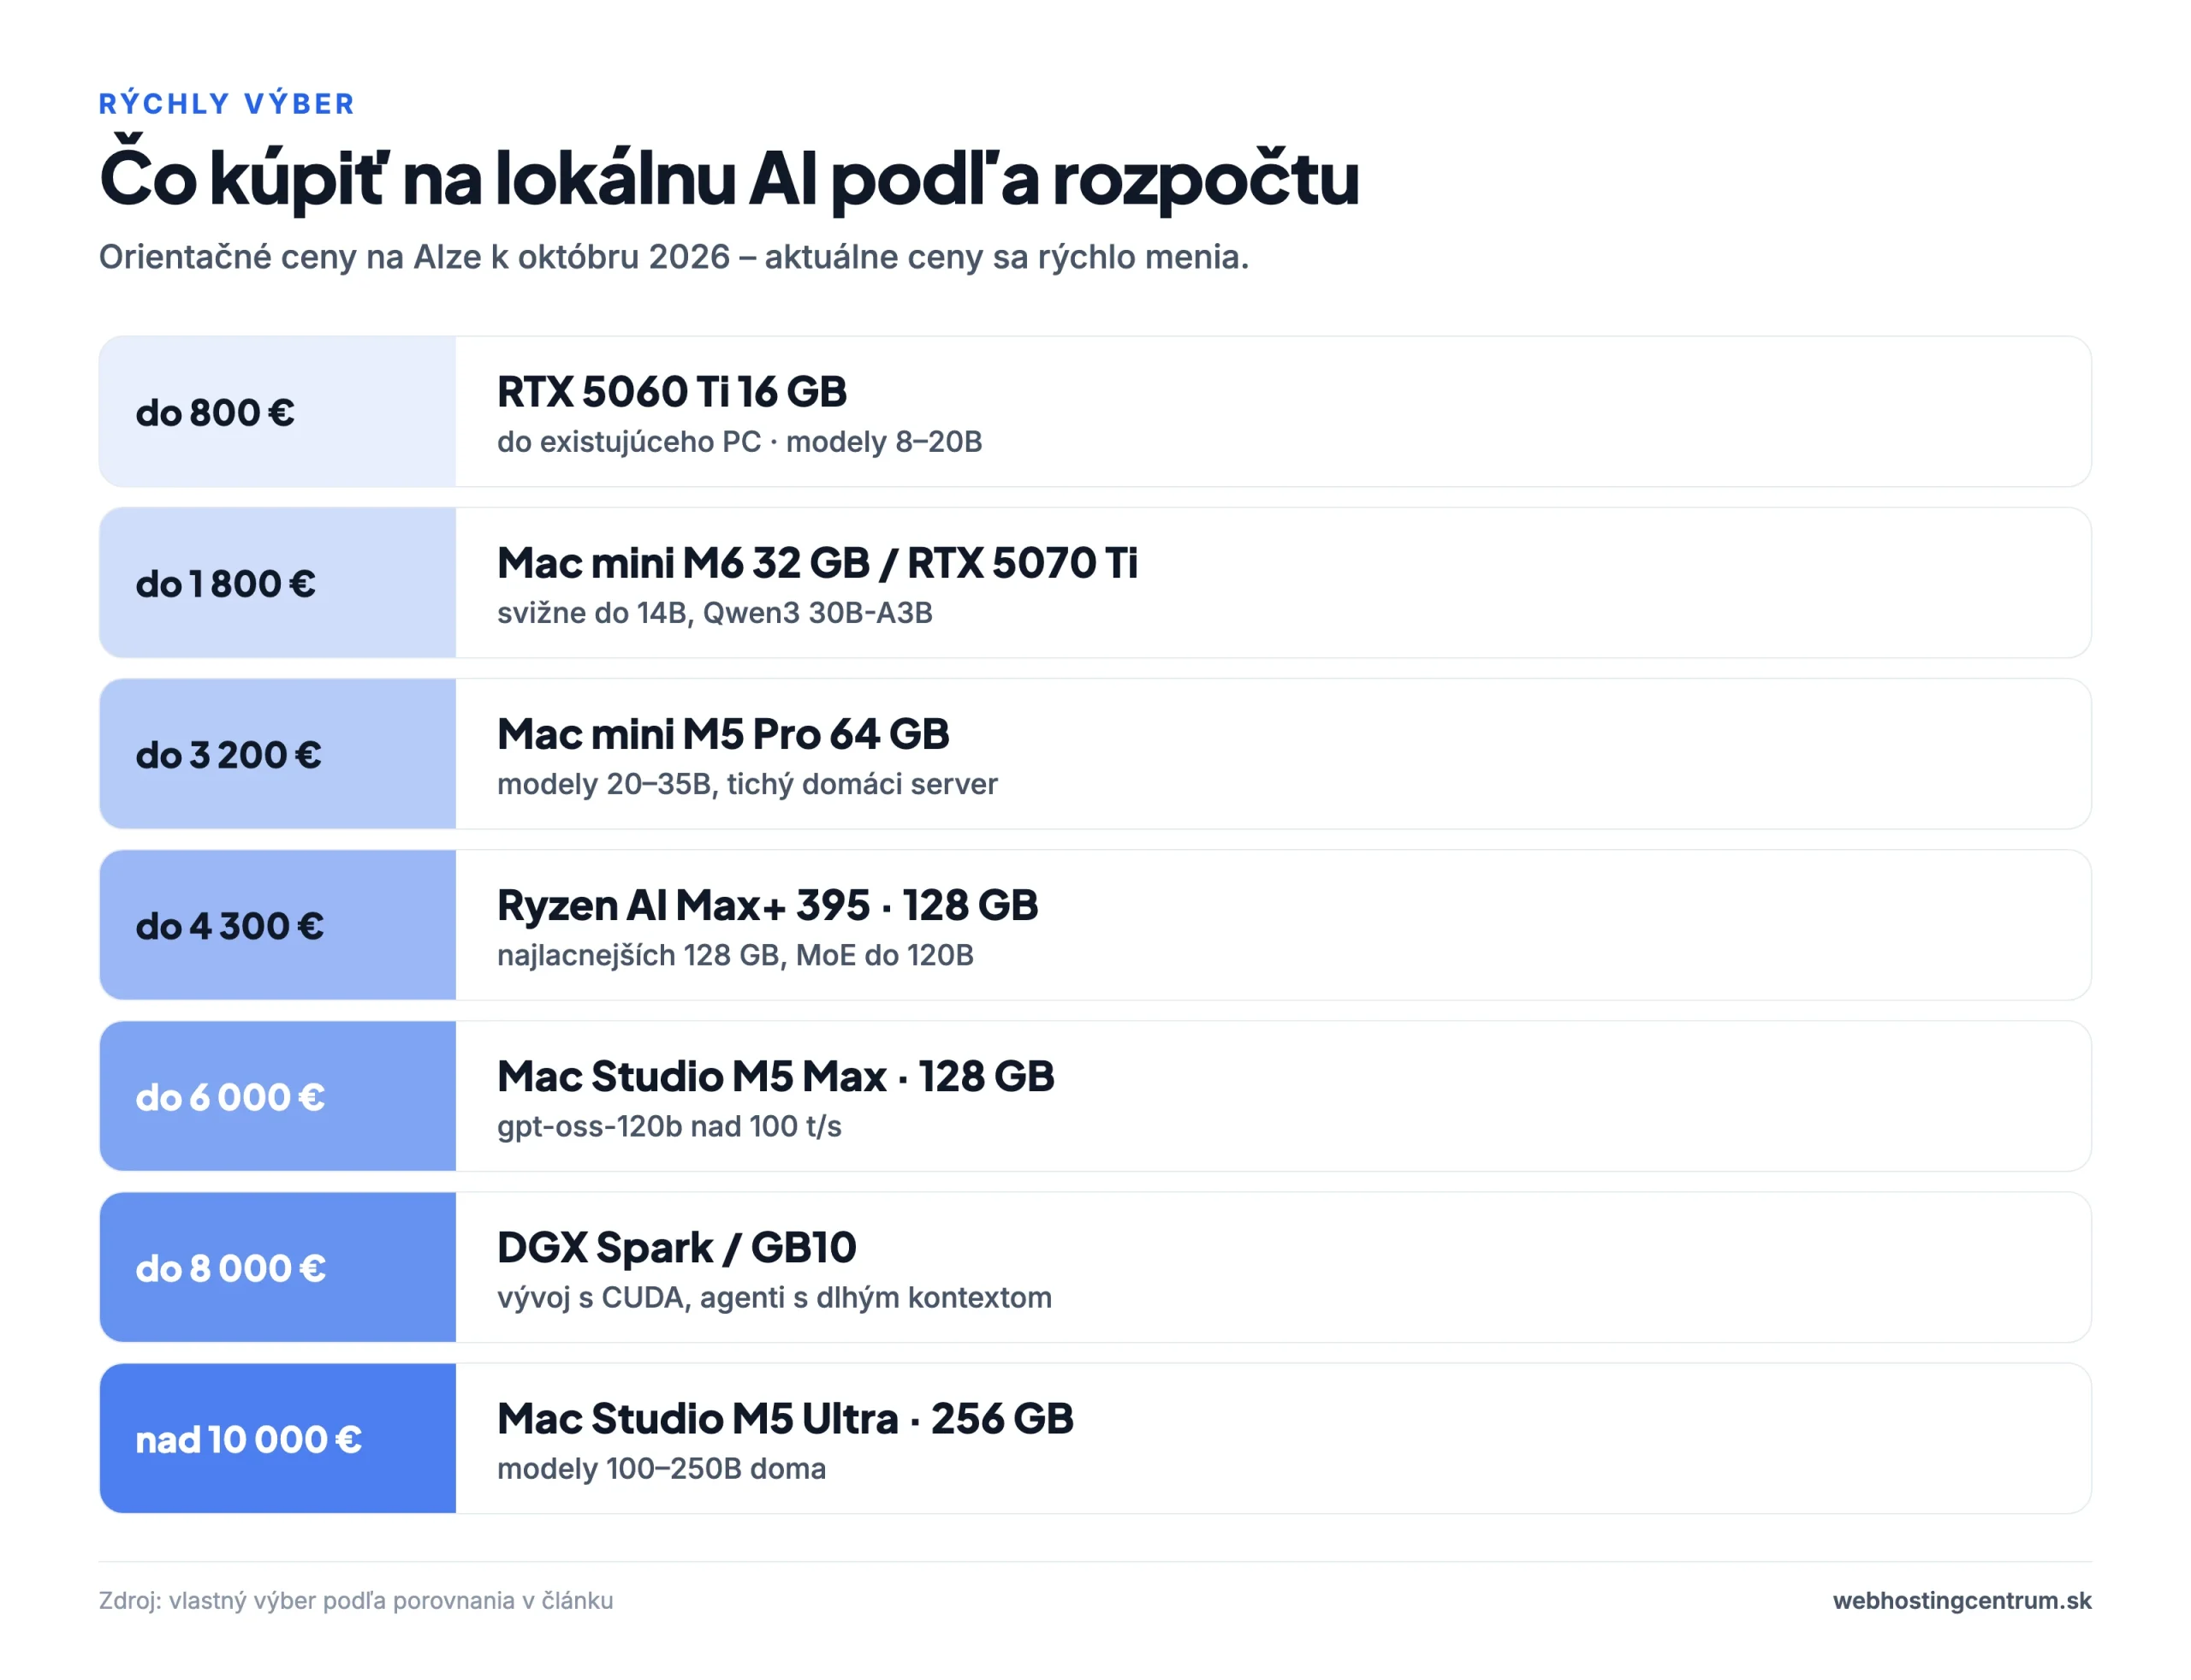
Ak nechcete čítať celý článok, tu je skratka. Každé odporúčanie nižšie podrobne rozoberáme, pri vybraných aj s videom.
| Rozpočet | Odporúčanie | Na aké modely |
|---|---|---|
| do 800 € | RTX 5060 Ti 16 GB do existujúceho PC | 8–20B (Qwen3 14B, gpt-oss-20b) |
| do 1 800 € | Mac mini M6 s 32 GB alebo RTX 5070 Ti | do 14B svižne, Qwen3 30B-A3B |
| do 3 200 € | Mac mini M5 Pro so 64 GB | 20–35B, tichý domáci server |
| do 4 300 € | Ryzen AI Max+ 395 so 128 GB | veľké MoE modely do 120B |
| do 6 000 € | Mac Studio M5 Max so 128 GB | gpt-oss-120b cez 100 tokenov/s |
| do 8 000 € | DGX Spark alebo iný GB10 | vývoj s CUDA, programovací agenti |
| nad 10 000 € | Mac Studio M5 Ultra s 256 GB | modely 100–250B doma |
| firmy | RTX PRO 6000 v AlzaPC VisionBox PRO | 70–120B pre celý tím |
Prečo lokálna AI – a čo od nej nečakať
Lokálny model beží na vašom počítači. Dáta neopúšťajú stôl, neplatíte mesačné predplatné ani poplatky za tokeny, model funguje aj bez internetu a nikto vám ho zo dňa na deň nezmení. Hodí sa preto na prácu s citlivými dokumentmi, na programovacích asistentov nad firemným kódom, na automatizácie, ktoré posielajú tisíce dopytov denne, alebo jednoducho pre radosť z experimentovania.
Má to však dve dane. Po prvé, otvorené modely, ktoré sa zmestia do domáceho hardvéru, sú múdre, ale nie na úrovni najlepších cloudových služieb. Po druhé, hardvér nie je lacný – a jeho cena v roku 2026 pre nedostatok pamätí rastie. Hlavným dôvodom pre lokálnu AI je preto súkromie, kontrola a nezávislosť, nie úspora.
Ako model na počítači beží
Keď modelu pošlete otázku, prebehnú dve fázy a každú brzdí niečo iné:
- Čítanie promptu (prefill). Model spracuje celý váš vstup naraz – otázku, vložený dokument, kód projektu. Tu rozhoduje výpočtový výkon grafiky. Určuje, ako dlho čakáte na prvé slovo odpovede. Pri krátkom dopyte je to zlomok sekundy, pri dokumente s desiatkami tisíc slov aj minúty.
- Písanie odpovede (decode). Model generuje text slovo po slove (presnejšie token po tokene). Pre každý token musí z pamäte prečítať celý model – pri modeloch typu mixture of experts len jeho aktívnu časť. Tu rozhoduje priepustnosť pamäte, teda koľko gigabajtov za sekundu dokáže čip prečítať.
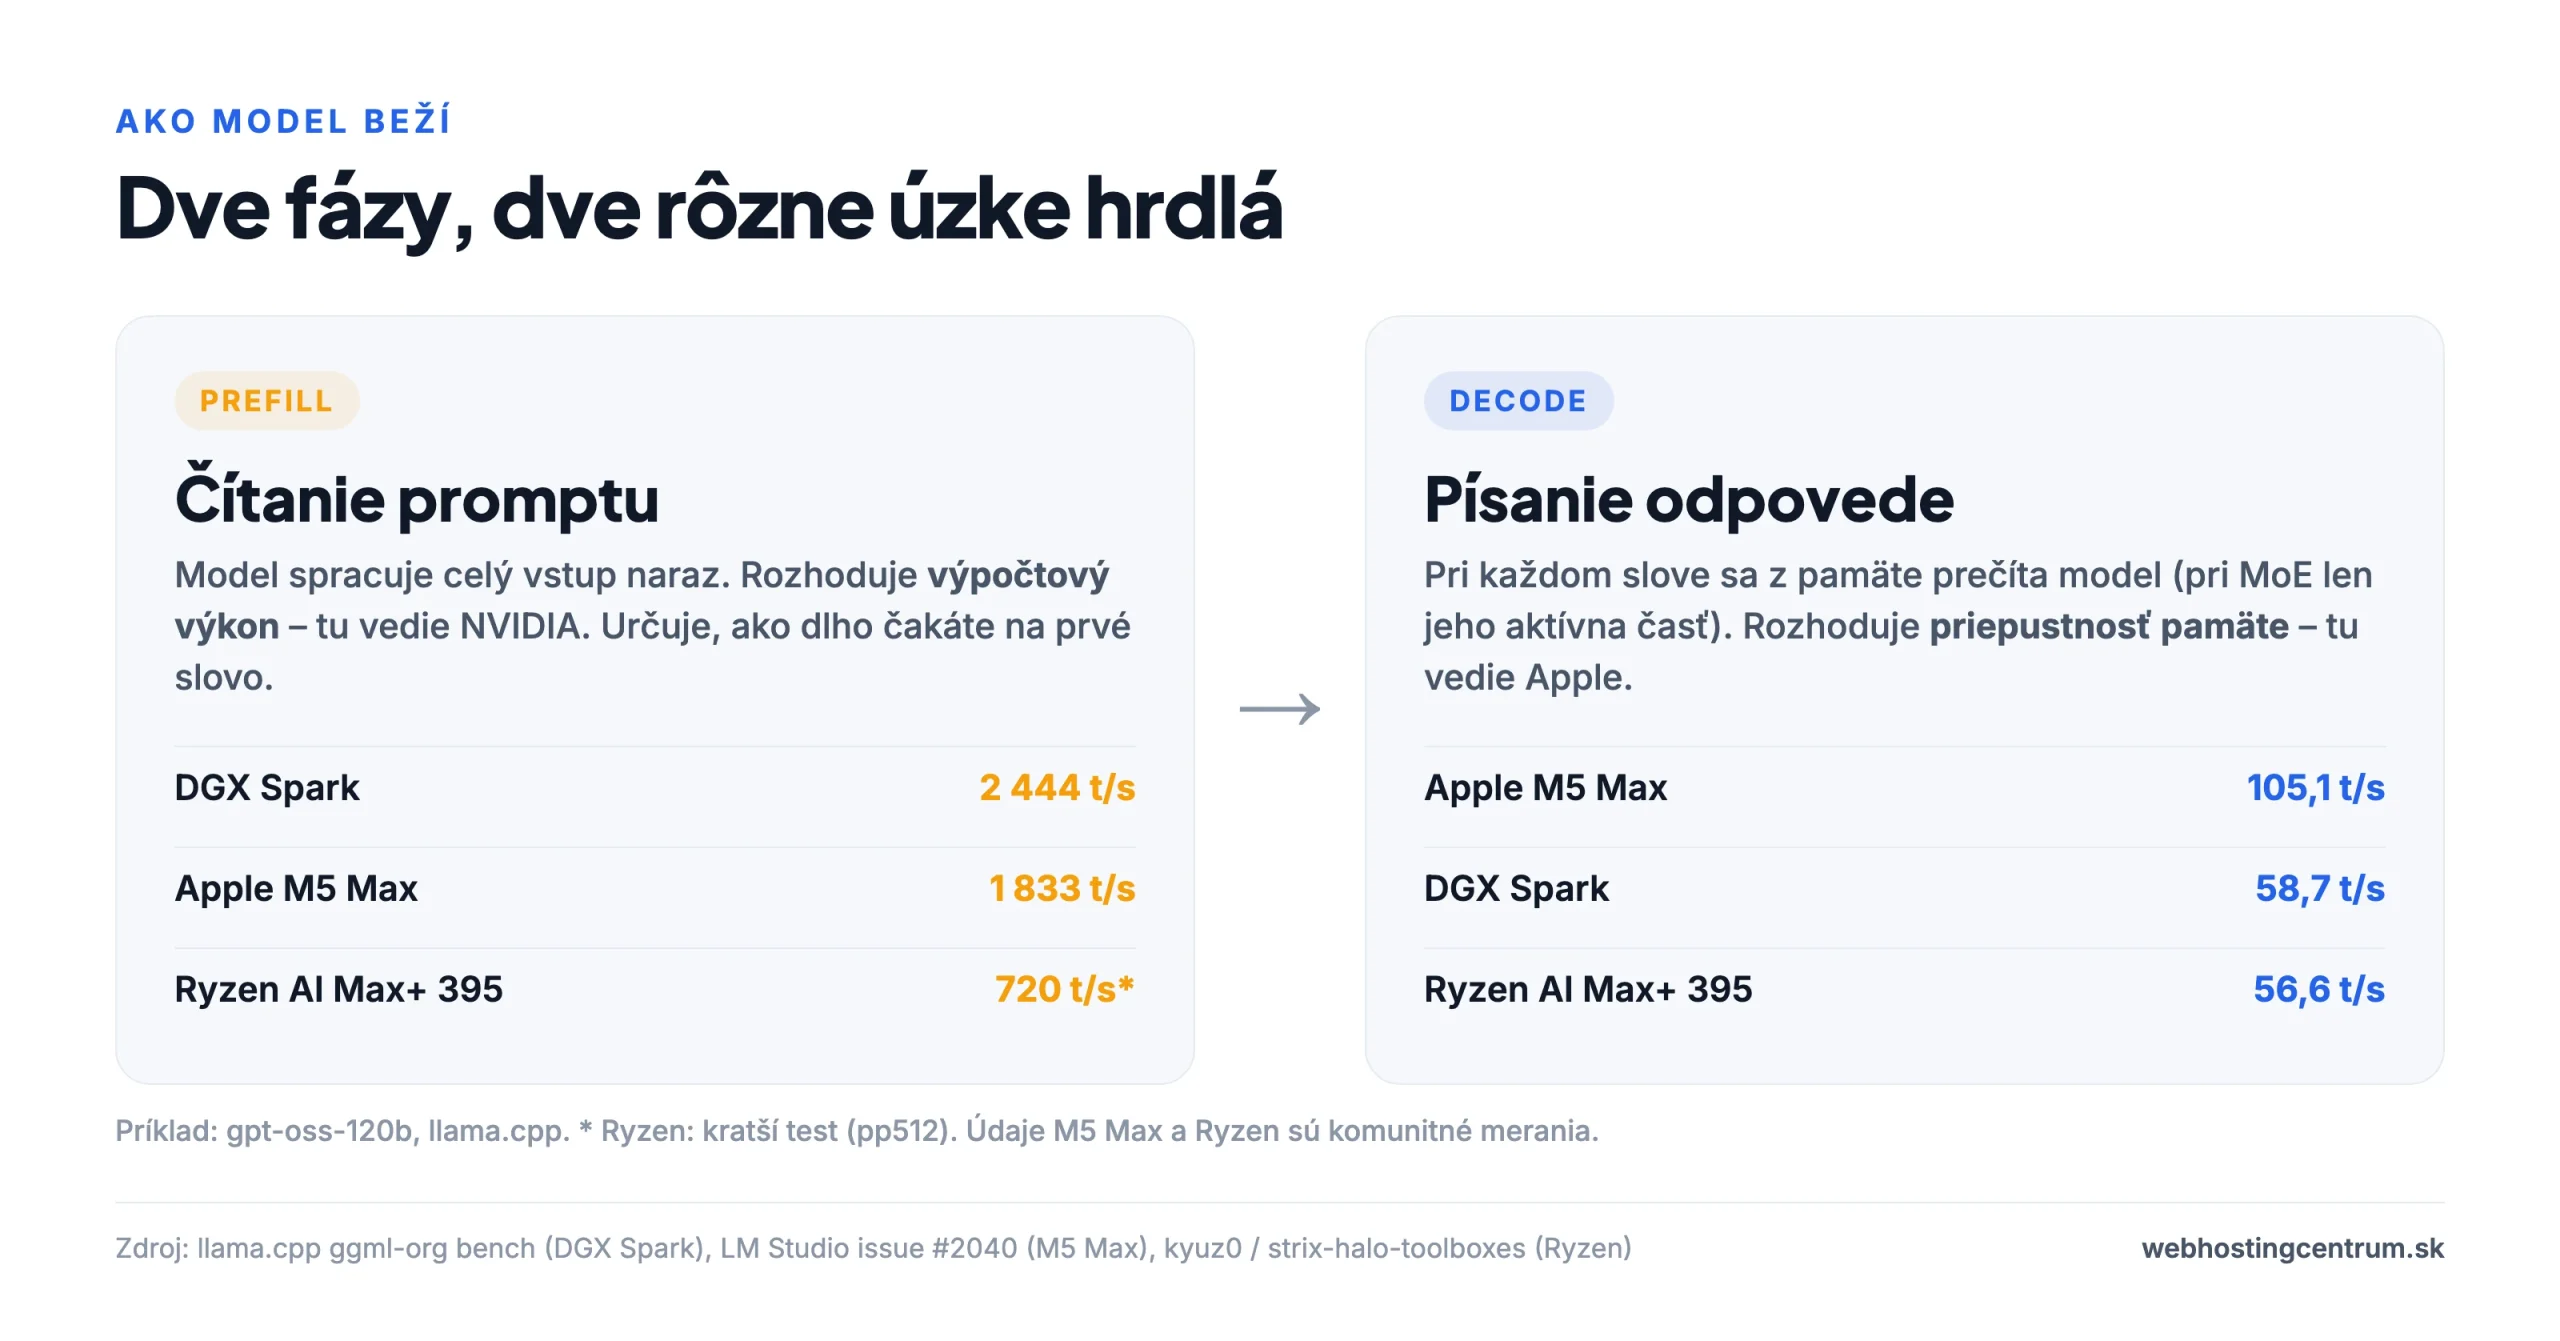
Z toho vyplýva praktický rozdiel: na chat stačí rýchle písanie (Mac je tu skvelý), na programovacích agentov a prácu s dokumentmi, ktoré modelu neustále posielajú obrovský kontext, je dôležité aj rýchle čítanie promptu (tu vedie NVIDIA). Rýchlosť sa meria v tokenoch za sekundu – jeden token je zhruba tri štvrtiny slova. Okolo 15 tokenov za sekundu zodpovedá rýchlosti čítania, nad 50 pôsobí model svižne.
Koľko pamäte potrebujete
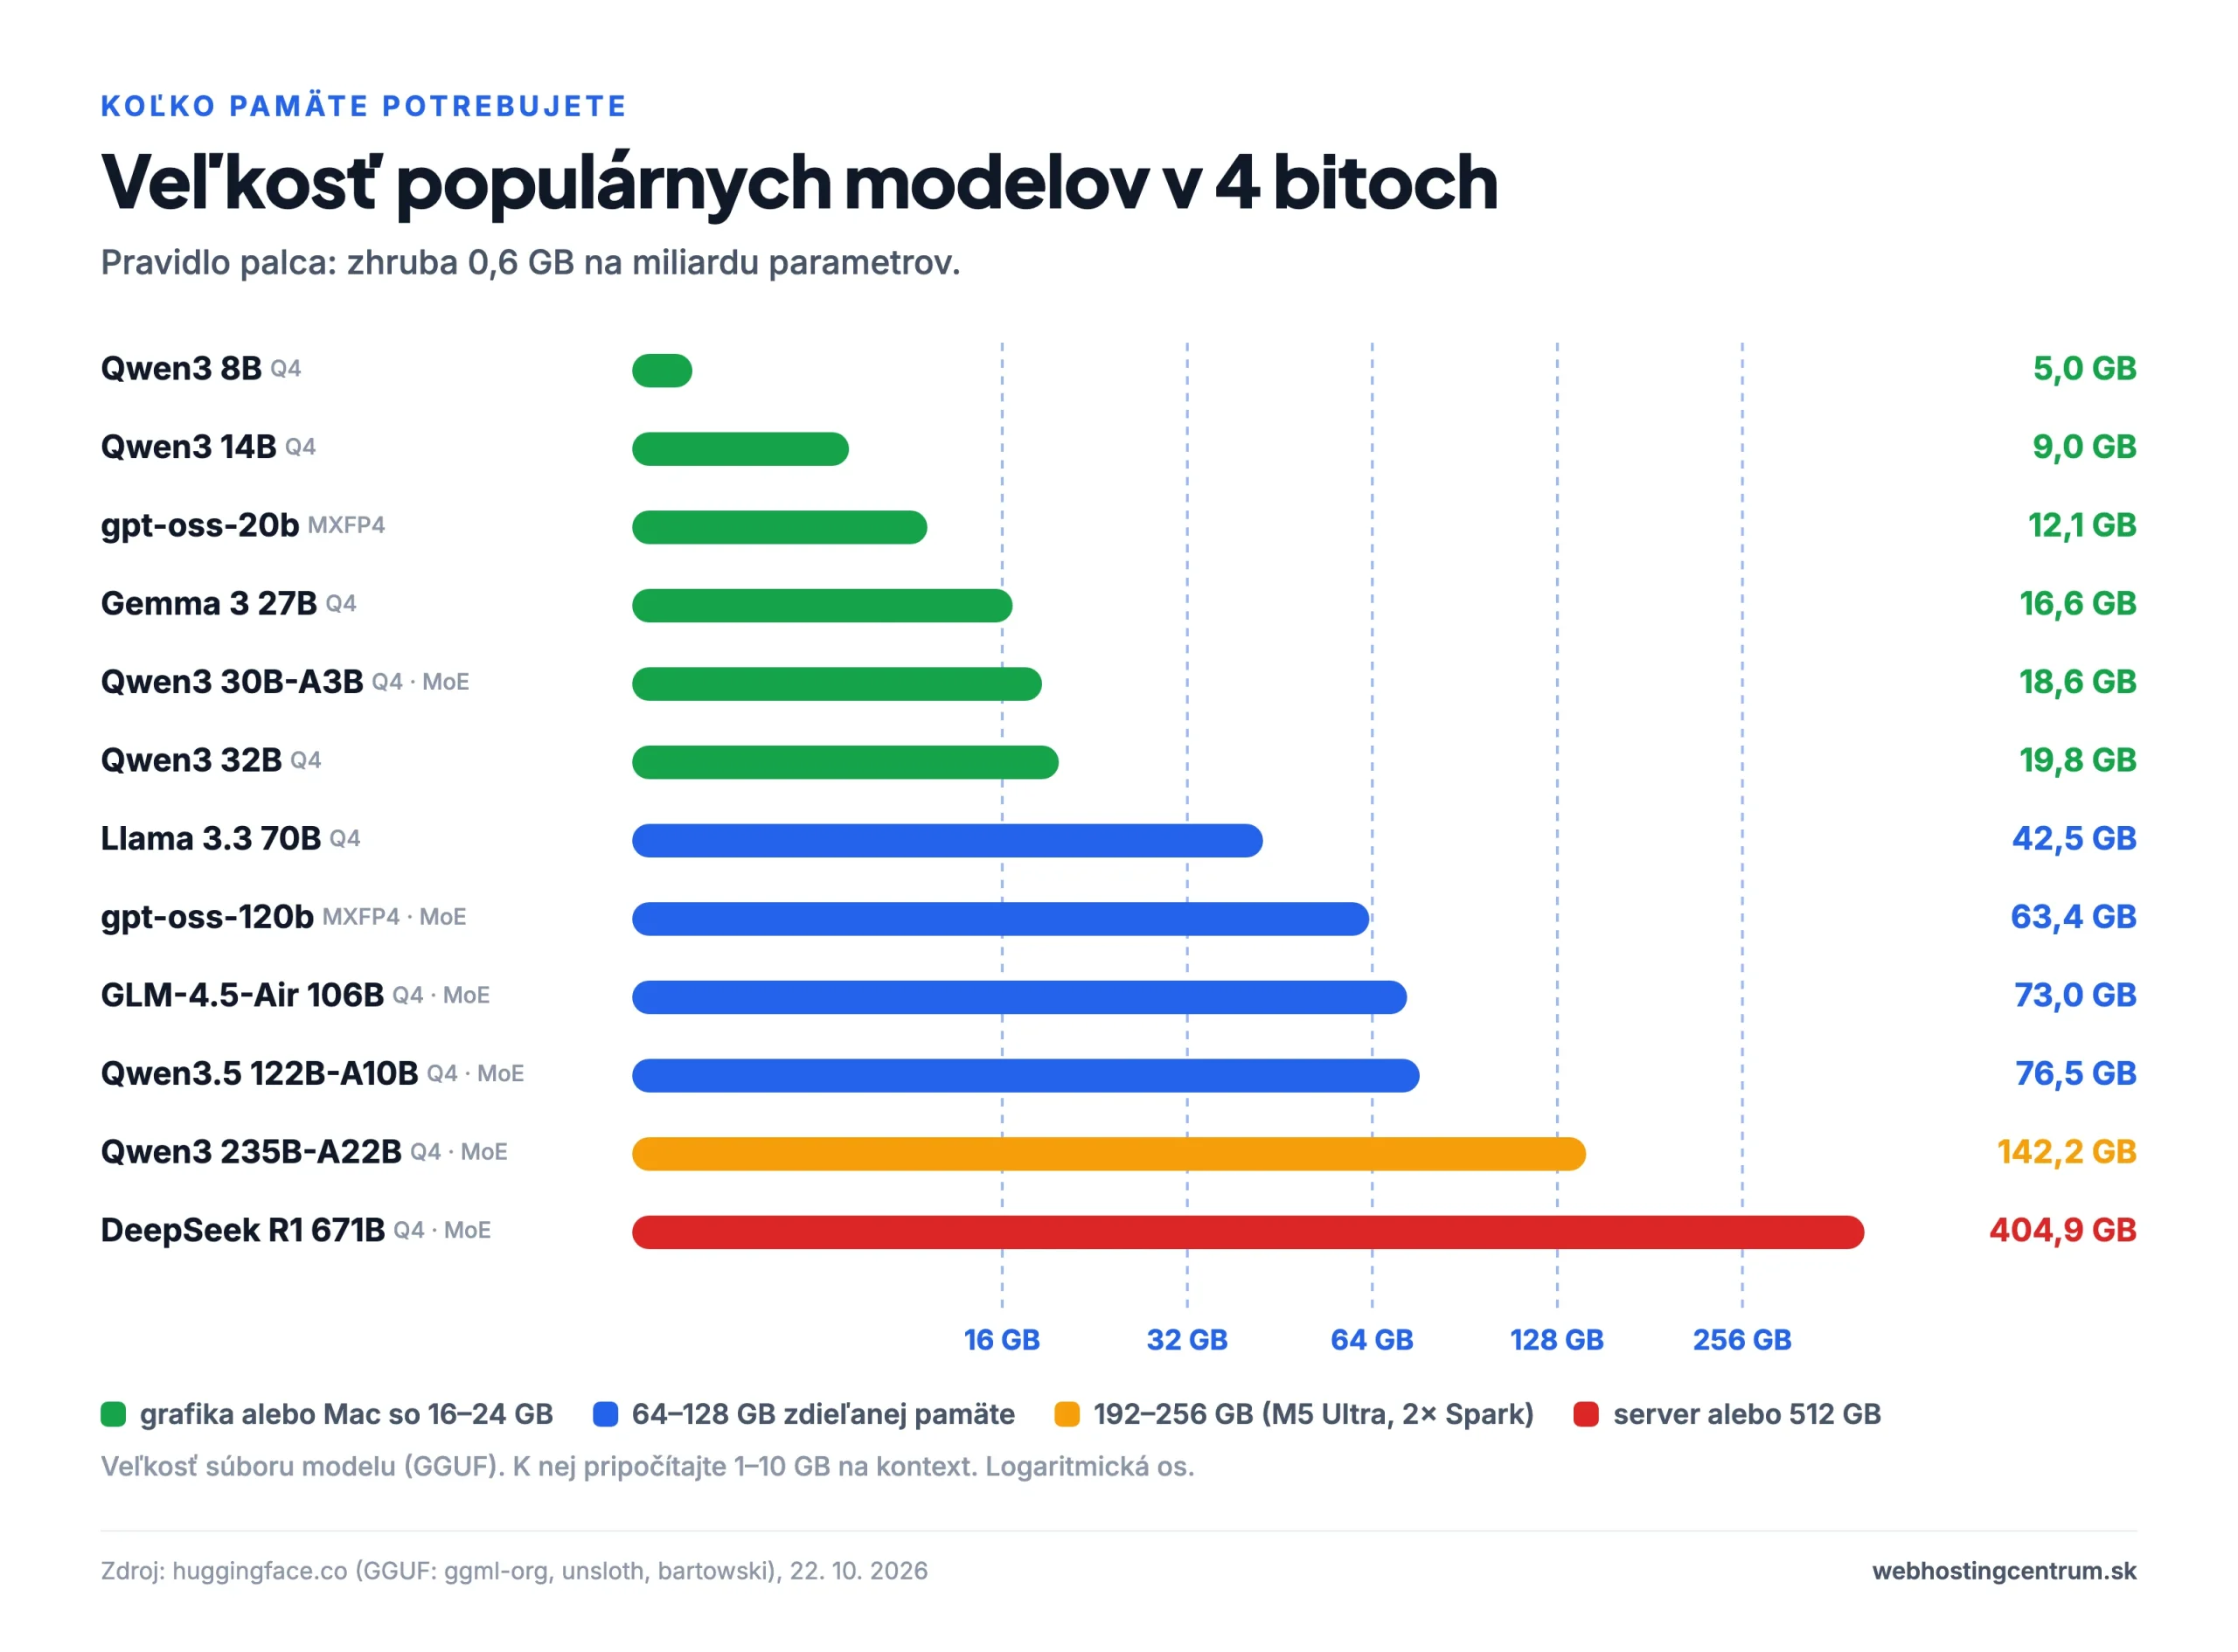
Model musí celý ležať v rýchlej pamäti, ku ktorej má prístup grafika: buď vo VRAM grafickej karty, alebo v zdieľanej (unified) pamäti, akú majú Macy, DGX Spark alebo Ryzen AI Max. Keď sa nezmestí, časť putuje do bežnej RAM a rýchlosť sa zrúti. V jednom meraní na RTX 5060 Ti stačilo presunúť šestinu vrstiev modelu Qwen 14B mimo grafiku a rýchlosť písania klesla zo 43 na 12,5 tokenov za sekundu; bez grafiky, len na procesore, to bolo 2,9.
| Model | Typ | Veľkosť (4 bity) | Kam sa zmestí |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | hustý | 4,9–5,0 GB | čokoľvek s 8 GB |
| Qwen3 14B | hustý | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | hustý | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B aktívnych | 18,6 GB | 24 GB |
| Qwen3 32B | hustý | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | hustý | 42,5 GB | 48 GB a viac |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | 96 GB a viac |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
Kontext stojí ďalšiu pamäť
K samotnému modelu treba pripočítať pamäť na kontext (tzv. KV cache) – teda na všetko, čo si model z rozhovoru alebo dokumentu „pamätá“. Pri Llama 3.3 70B je to pri kontexte 32 000 tokenov asi 10 GB navyše, pri 128 000 tokenoch okolo 40 GB. Modely gpt-oss sú vďaka posuvnému oknu oveľa úspornejšie: gpt-oss-120b potrebuje aj pre 128 000 tokenov najviac okolo 9 GB. Rýchlosť písania s dĺžkou kontextu tiež klesá – gpt-oss-120b na M5 Max píše pri krátkom kontexte okolo 80 tokenov za sekundu, pri 128 000 tokenoch len 14.
Nie všetka pamäť patrí grafike
- macOS dovolí grafike v predvolenom stave zhruba 75 % RAM (Apple presné číslo neuvádza). Mac so 64 GB teda pre model ponúkne asi 48 GB, so 128 GB asi 96 GB. Limit sa dá zvýšiť príkazom
sudo sysctl iogpu.wired_limit_mb=…, po reštarte sa však vráti. - Windows na Ryzene AI Max delí pamäť v BIOSe napevno – maximum pre grafiku je 96 GB zo 128 GB. V Linuxe to ide až k 124 GB.
- Notebooky s NVIDIA RTX Spark majú vo Windows predvolený pomer zhruba 50 : 50, ručne najviac 96 GB zo 128 GB. Verzia s 32 GB dá grafike len 16 GB.
- DGX Spark s Linuxom pamäť prideľuje dynamicky, model môže využiť väčšinu zo 128 GB.
Kvantizácia a MoE jednoducho
Kvantizácia je kompresia modelu: namiesto 16 bitov na parameter sa použije 8 alebo 4. V 4 bitoch (označenie Q4, Q4_K_M alebo MXFP4) zaberie model zhruba štvrtinu pôvodnej veľkosti a kvalita klesne len mierne – na domáce použitie je to rozumný štandard. Osem bitov (Q8) je takmer bez straty, ale dvakrát väčší.
Mixture of experts (MoE) je architektúra, pri ktorej má model veľa parametrov, ale pri každom slove počíta len malú časť z nich. gpt-oss-120b má 117 miliárd parametrov, ale v každom kroku ich zapojí len okolo piatich miliárd; Qwen3 30B-A3B len tri. Takýto model potrebuje veľkú pamäť, ale píše rýchlosťou oveľa menšieho modelu. Preto sú MoE modely ideálne pre zariadenia s veľkou, ale pomalšou zdieľanou pamäťou – DGX Spark, Ryzen AI Max alebo Macy. Husté modely (Llama 70B, Qwen3 32B) naopak pri každom slove čítajú celý model a na pomalej pamäti sa vlečú.
Priepustnosť pamäte: prečo Mac píše rýchlejšie ako Spark
Rýchlosť písania sa dá celkom dobre odhadnúť: priepustnosť pamäte vydelená tým, koľko dát musí model prečítať na jeden token. Hustý 70B model v 4 bitoch (~42 GB) preto na DGX Sparku s 273 GB/s nemôže písať rýchlejšie ako asi 6–7 tokenov za sekundu – a merania ukazujú okolo 4,4.
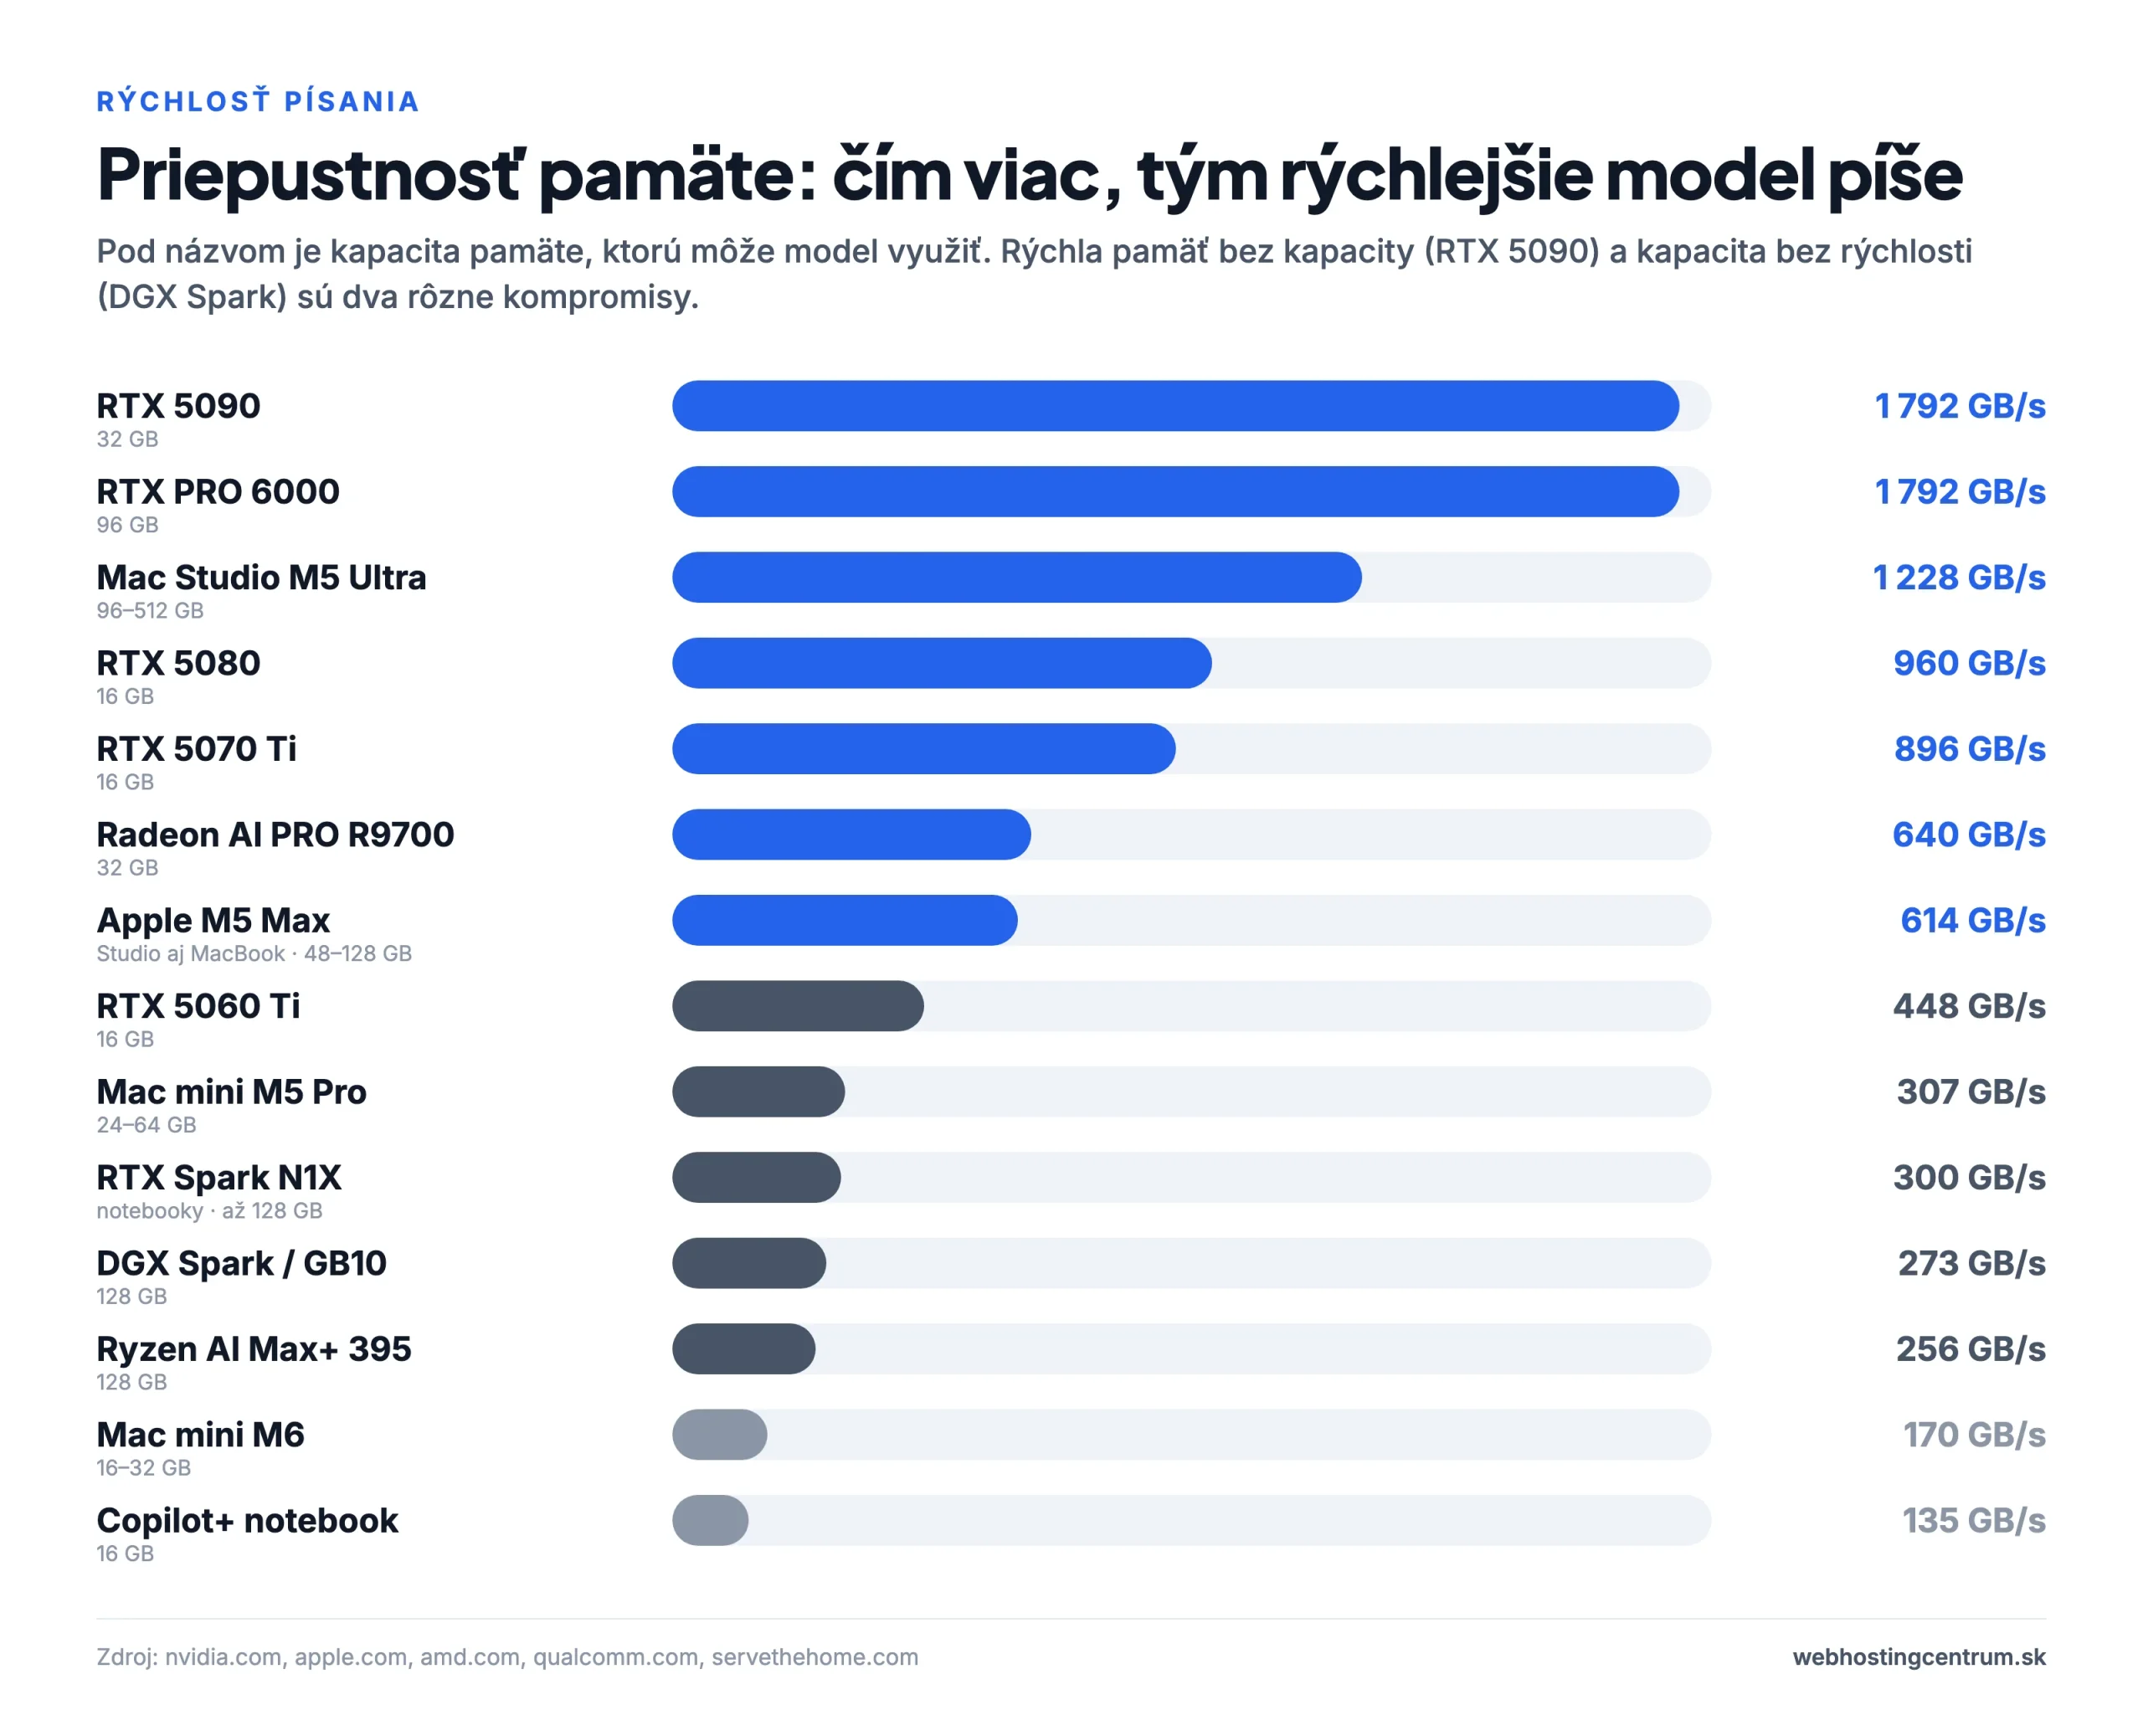
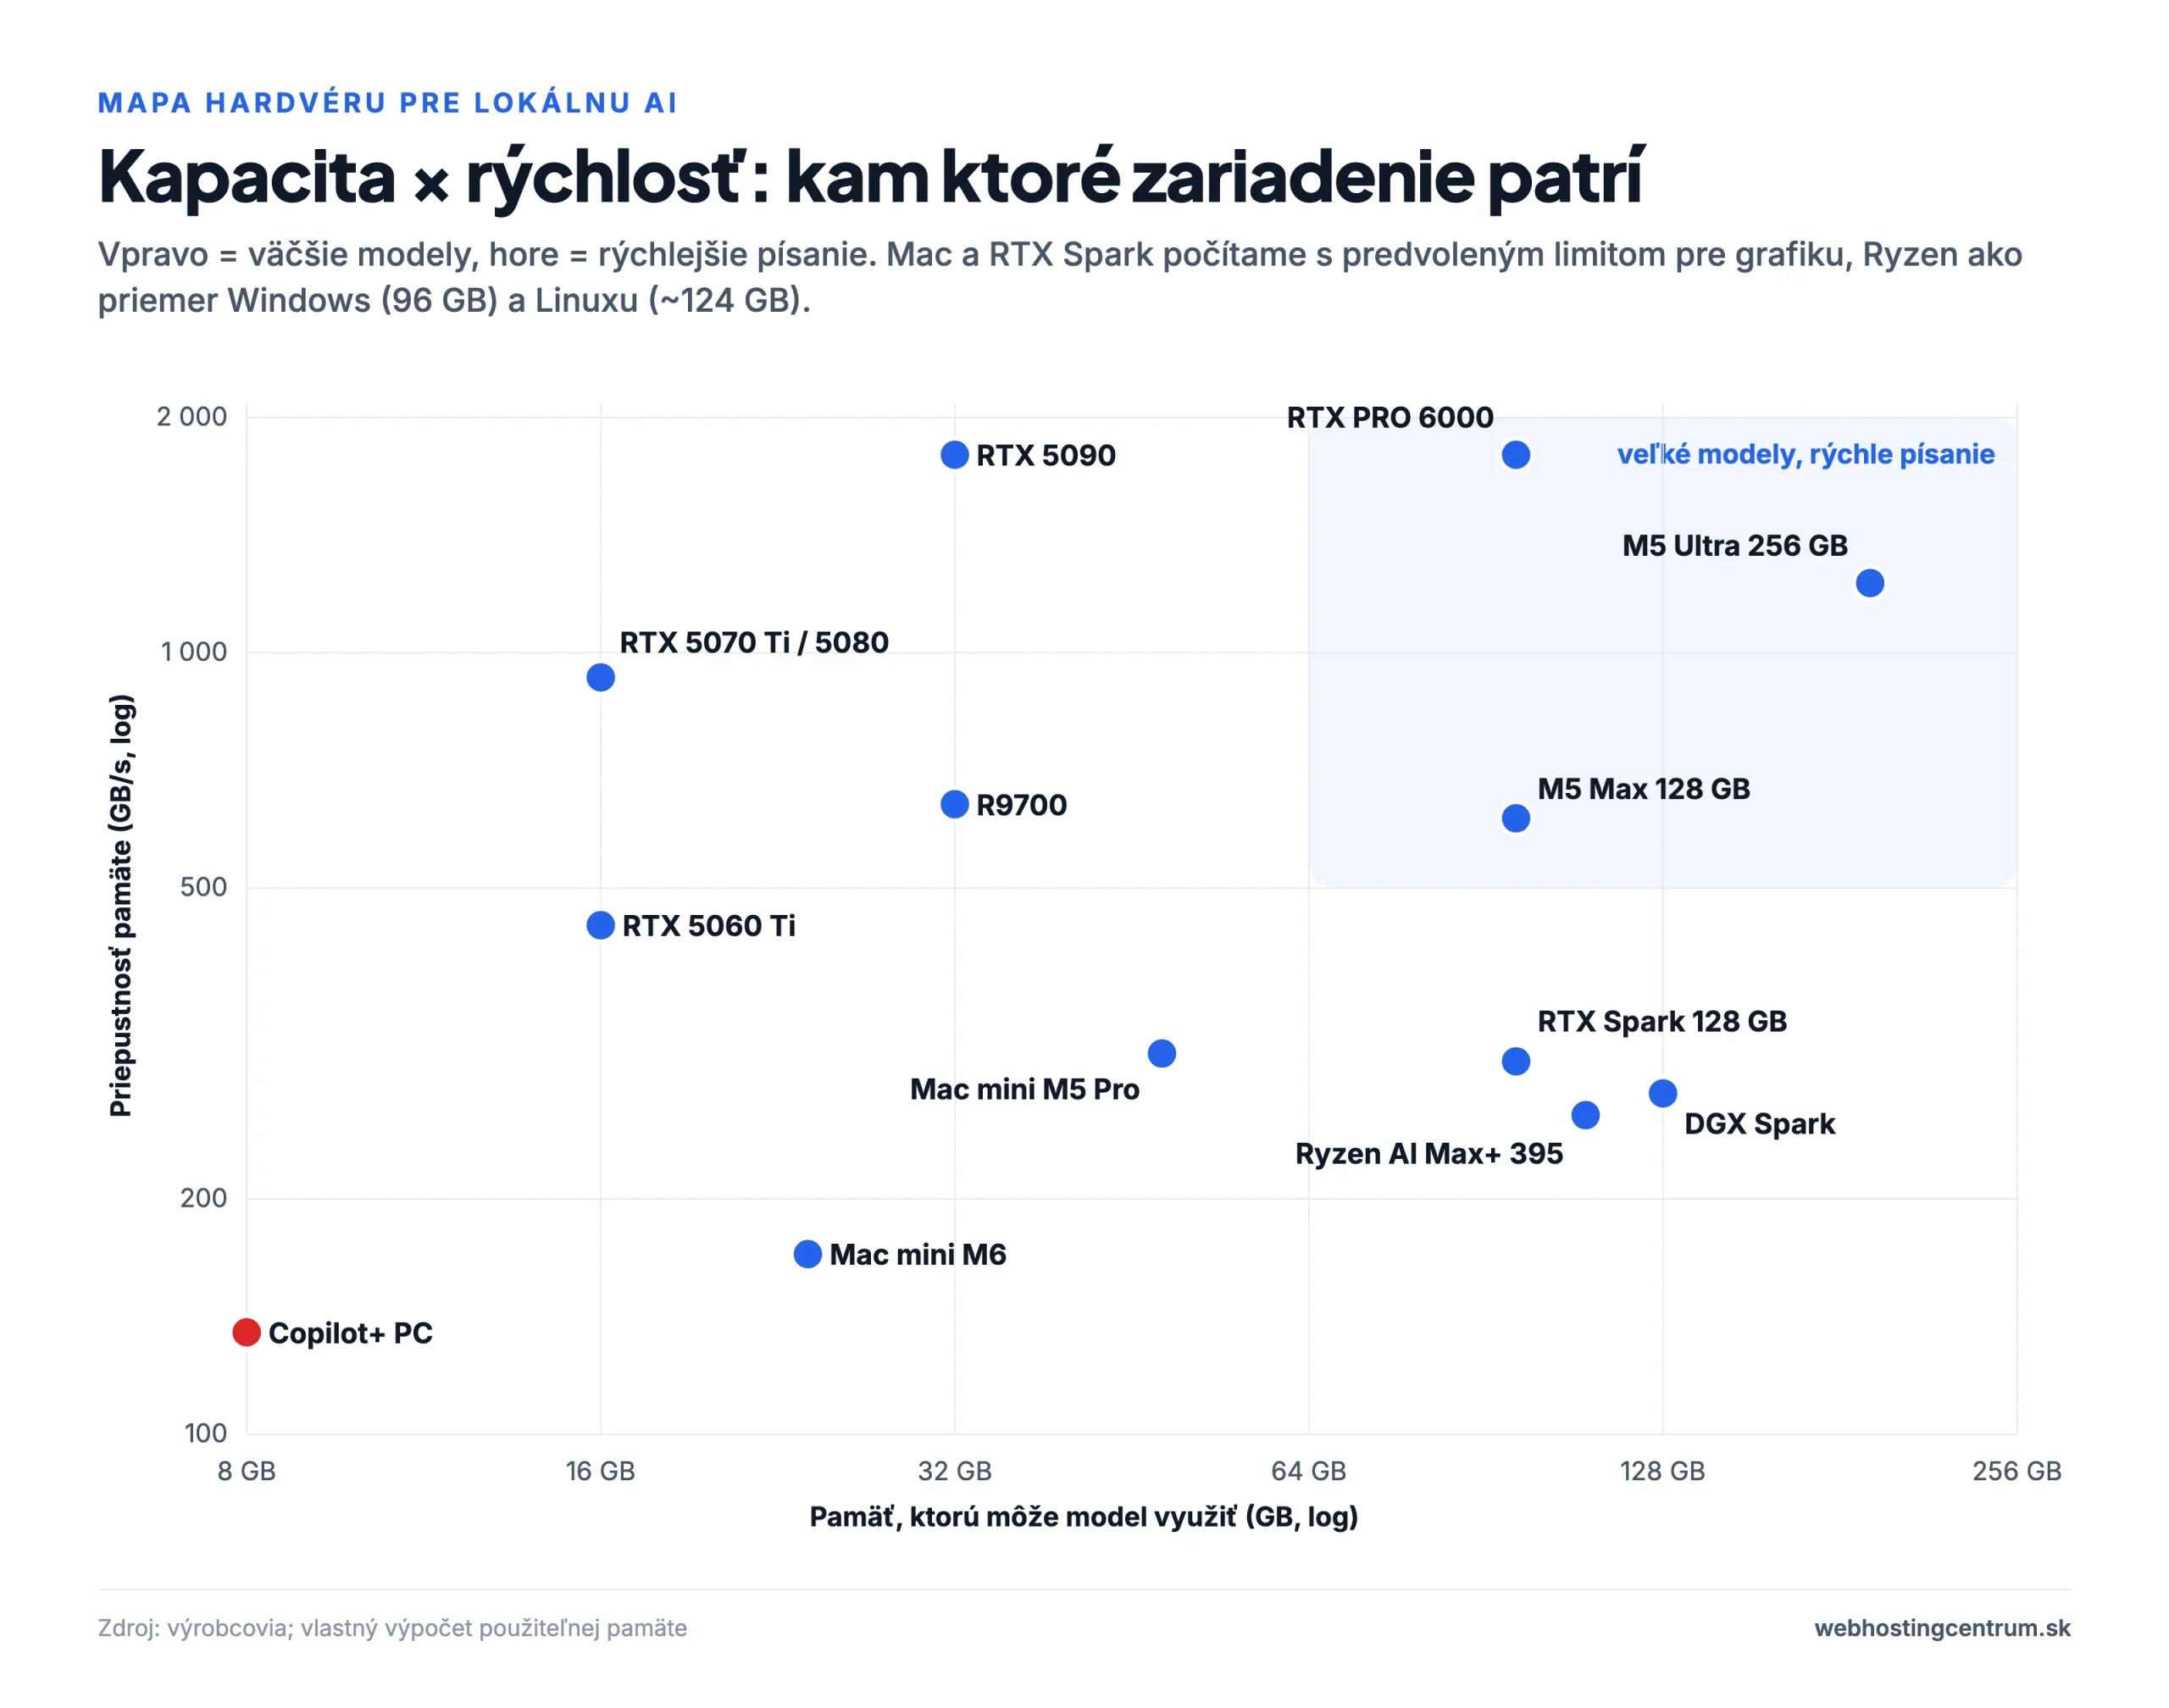
Z mapy je vidieť, že dokonalé zariadenie neexistuje. Grafické karty NVIDIA majú najrýchlejšiu pamäť, ale málo kapacity. DGX Spark, Ryzen AI Max a RTX Spark majú veľkú kapacitu, ale pomalšiu pamäť. Mac Studio s M5 Max a hlavne M5 Ultra kombinujú oboje – za cenu chýbajúcej CUDA a pomalšieho čítania promptu než pri NVIDII.
Rovnaký model, rôzny hardvér
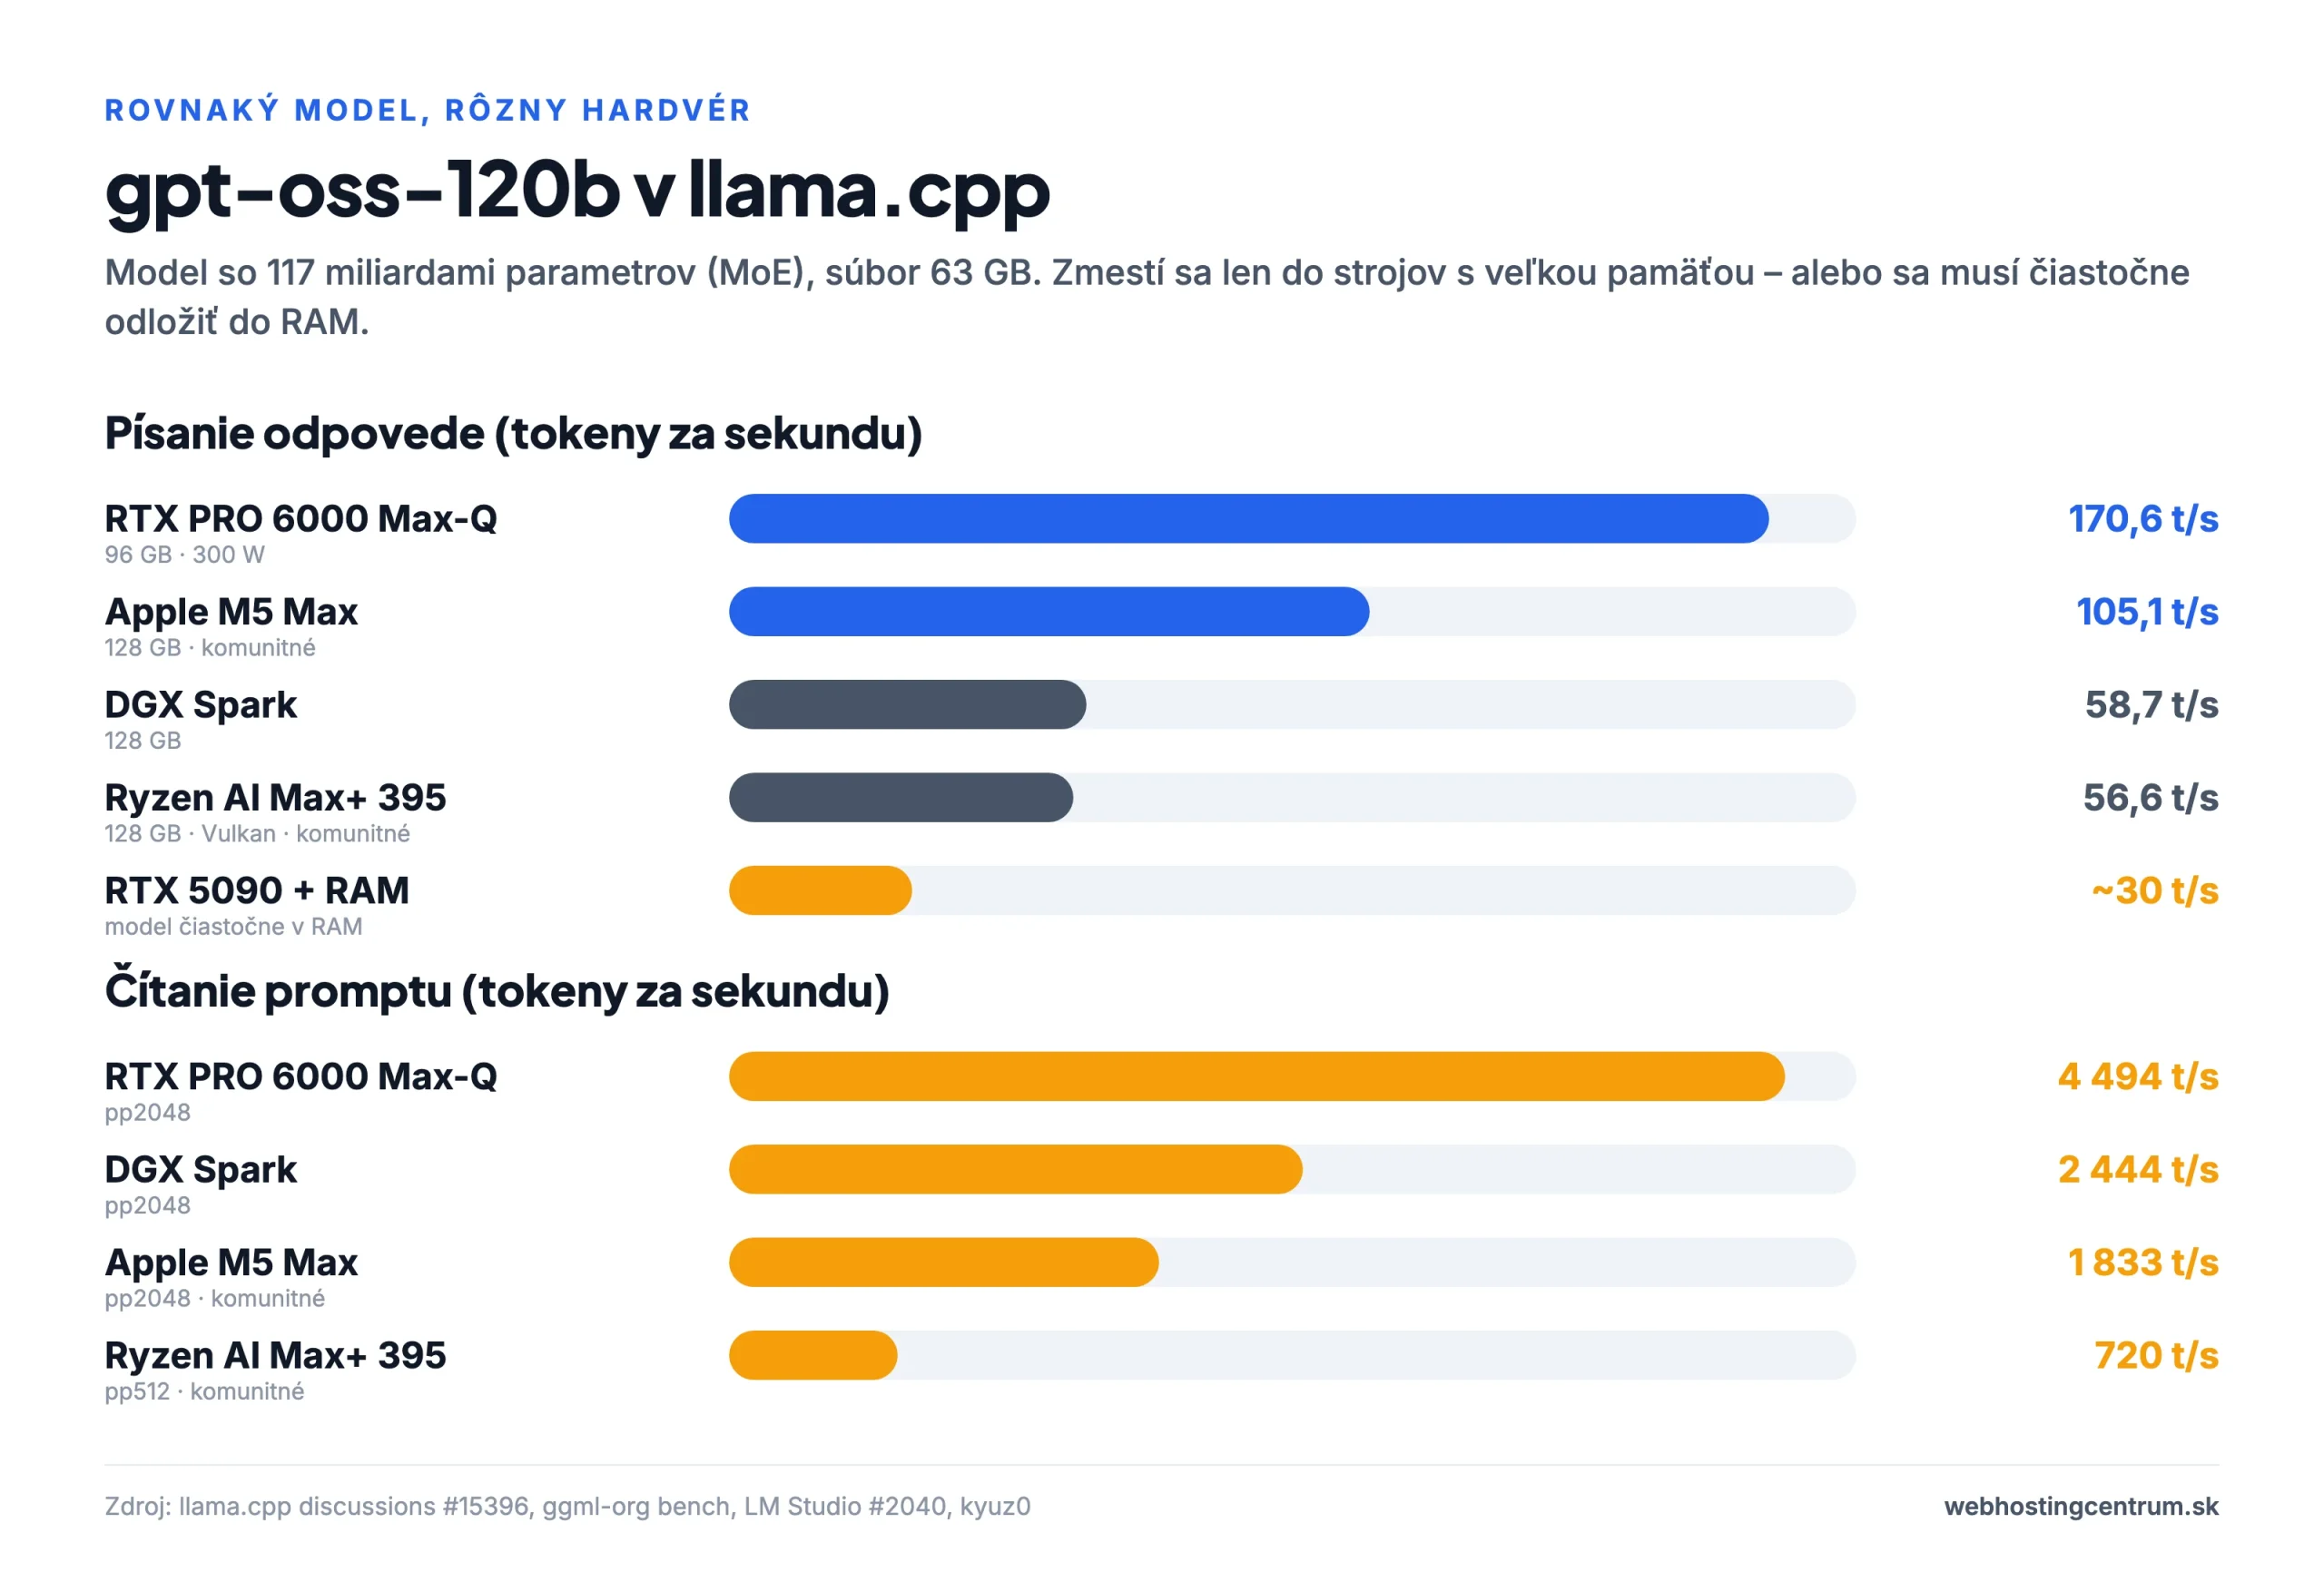
Najférovejšie porovnanie je na rovnakom modeli v rovnakom programe. Vybrali sme gpt-oss-120b od OpenAI (63 GB) a merania z llama.cpp, najrozšírenejšieho programu na lokálne modely.
Porovnanie všetkých zariadení
| Zariadenie | Pamäť pre AI | Priepustnosť | gpt-oss-120b, písanie | Alza.sk, táto pamäť |
|---|---|---|---|---|
| Mac Studio M5 Max | ~96 GB zo 128 GB | 614 GB/s | 105 t/s¹ | 5 909 € |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s | 7 969 € |
| Notebooky RTX Spark | max. 96 GB zo 128 GB | až 300 GB/s | – | 5 245 € |
| Ryzen AI Max+ 395 | 96 GB (Win) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s | 4 219 € |
| Mac Studio M5 Ultra | ~192 GB z 256 GB | 1 228 GB/s | – | 11 099 € |
| Mac mini M5 Pro | ~48 GB zo 64 GB | 307 GB/s | nezmestí sa | 3 129 € |
| Mac mini M6 | ~24 GB z 32 GB | 170 GB/s | nezmestí sa | 1 739 € |
| MacBook Pro M5 Max | ~96 GB zo 128 GB | 614 GB/s | 105 t/s¹ | 7 759 € |
| RTX 5090 | 32 GB | 1 792 GB/s | ~30 t/s² | 4 719 € |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | nezmestí sa | 762,90 € |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | nezmestí sa | 1 259 € |
| RTX PRO 6000 Max-Q | 96 GB | 1 792 GB/s | 170,6 t/s | len na alza.cz |
| GB10 od ASUS, MSI, Lenova… | 128 GB | 273 GB/s | ~ ako Spark | 7 108,99 € |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | nezmestí sa | 2 219 € |
| Copilot+ notebooky | ~8 GB zo 16 GB | ~135 GB/s | nezmestí sa | 899 € |
¹ Komunitné meranie na MacBooku Pro M5 Max so 128 GB, llama.cpp. ² Časť modelu odložená do systémovej RAM. Ceny sú za konfiguráciu s uvedenou pamäťou (pri kartách za samotnú kartu), stav k 22. 10. 2026.
1. Mac Studio M5 Max – najrýchlejšie písanie za svoje peniaze
Mac Studio s čipom M5 Max je dnes najrozumnejšia voľba pre toho, kto chce čo najrýchlejší lokálny chat alebo agenta a nepotrebuje CUDA. Pamäť s priepustnosťou 614 GB/s dáva vo verzii so 128 GB modelu gpt-oss-120b rýchlosť cez 100 tokenov za sekundu – takmer dvakrát viac ako DGX Spark. Nové neurálne akcelerátory v každom grafickom jadre zrýchlili aj čítanie promptu, ale len v aktuálnom softvéri (pozri nastavenie softvéru).
- Pamäť: 36, 48, 64 alebo 128 GB · priepustnosť 460 GB/s (36 GB) / 614 GB/s
- Spotreba: 7 W v pokoji, max. 200 W
- Porty: 4× Thunderbolt 5, 10GbE
- Pozor: verzia s 36 GB má slabšiu 32-jadrovú grafiku a pre model zostane len okolo 27 GB. Od 48 GB dostanete plný čip.
Pre koho: chat a agenti s MoE modelmi, tichý domáci AI server, kto robí aj video. Pre koho nie: kto potrebuje CUDA, vLLM alebo tréning.
Na Alze: 64 GB za 4 149 €, 128 GB za 5 909 €.
2. NVIDIA DGX Spark – stanica pre vývojárov, nie na chat
Čip GB10 so 128 GB zdieľanej pamäte a kompletným softvérom NVIDIA (CUDA, vLLM, TensorRT-LLM) v krabičke 15 × 15 cm. Prompt číta najrýchlejšie z malých strojov – gpt-oss-120b 2 444 tokenov za sekundu – ale s priepustnosťou 273 GB/s píše pomalšie ako Mac: 58,7 tokenov za sekundu, hustá Llama 70B len 4,4. Pri behu modelu berie 60–90 W a dva kusy sa dajú prepojiť káblom QSFP pre modely až okolo 400 miliárd parametrov.
- Pamäť: 128 GB LPDDR5x · priepustnosť 273 GB/s
- Grafika: Blackwell, 6 144 jadier CUDA · AI výkon 1 PFLOP FP4 (so sparsity, reálne zhruba polovica)
- Systém: DGX OS (Ubuntu na Arm)
- Cena od uvedenia vyrástla z 3 999 na zhruba 6 950 dolárov
Pre koho: vývoj s CUDA, programovací agenti s veľkým kontextom, fine-tuning do 70B. Pre koho nie: rýchly chat s hustými 70B modelmi, Windows a hry, začiatočníci.
Na Alze: DGX Spark 4 TB za 7 969 €, stroje s rovnakým čipom od 7 108,99 € (porovnanie verzií).
3. Notebooky NVIDIA RTX Spark – 128 GB v batohu
Čip N1X je upravený GB10 pre notebooky s Windows, s rýchlejšou pamäťou (až 300 GB/s) a príkonom 45–80 W. V teste servera The Register písal notebook model Qwen3.6 35B-A3B rýchlosťou 67,6 tokenov za sekundu, teda rýchlejšie ako stolný DGX Spark. Háčik je vo Windows: grafika dostane napevno len časť pamäte – z 32 GB najviac 16 GB, zo 64 GB 48 GB, zo 128 GB 96 GB.
- Pamäť: 32, 64 alebo 128 GB · priepustnosť až 300 GB/s
- Grafika: Blackwell, 6 144 jadier (výkonom zhruba notebooková RTX 5070)
- Systém: Windows 11 na Arm, CUDA od verzie 13.4
- Pozor: prvé kusy (Surface, HP) v testoch pri hodinách plnej záťaže padali; Linux oficiálne nie je podporovaný
Pre koho: veľké modely v notebooku s Windows, programovací agenti, kreatívci. Pre koho nie: verzia s 32 GB, dlhý tréning, softvér len pre x86.
Na Alze: 64 GB od 3 969 € (Lenovo Yoga Pro 9), 128 GB od 5 245 €.
4. Ryzen AI Max+ 395 – najlacnejších 128 GB
Mini počítače so 16-jadrovým Ryzenom a grafikou Radeon 8060S zdieľajú 128 GB pamäte. Rýchlosť písania je porovnateľná s DGX Sparkom (gpt-oss-120b 56,6 tokenov za sekundu) za zhruba polovičnú cenu, beží na nich Windows aj Linux a zahráte si. Slabinou je čítanie promptu: je dvakrát až trikrát pomalšie ako pri Sparku a s dlhým kontextom klesá – v ovládači Vulkan na 146 tokenov za sekundu, v ROCm na 371.
- Pamäť: 128 GB LPDDR5x · priepustnosť 256 GB/s (namerané ~215)
- Pre grafiku: Windows 96 GB, Linux ~124 GB
- Softvér: Vulkan alebo ROCm (gfx1151 je od roku 2026 oficiálne podporovaný)
- HP Z2 Mini G1a je drahší, ale je to certifikovaná stanica s pamäťou ECC a trojročnou zárukou
Pre koho: čo najviac pamäte za euro, veľké MoE modely, chat a súhrny. Pre koho nie: agenti s obrovským kontextom, CUDA, tablet ROG Flow Z13 s 32–64 GB na veľké modely.
Na Alze: Acer Veriton RA110 a Acemagic A10A za 4 219 €, HP Z2 Mini G1a za 6 079 €.
5. Mac Studio M5 Ultra – kráľ pamäte
Až 512 GB pamäte a priepustnosť 1,2 TB/s. V teste MacStories čítal M5 Ultra prompt štyrikrát rýchlejšie ako predchádzajúci M3 Ultra a písal o polovicu rýchlejšie. Do verzie s 256 GB sa zmestí aj Qwen3 235B. Cez Thunderbolt 5 a technológiu RDMA sa dá prepojiť viac kusov: štyri M5 Ultra podľa Applu zvládnu model s 816 miliardami parametrov rýchlosťou 36,7 tokenov za sekundu.
- Pamäť: 96, 256 alebo 512 GB (512 GB prichádza koncom októbra) · priepustnosť 1 228 GB/s
- Spotreba: 9 W v pokoji, okolo 300 W pri behu modelu
- Porty: 6× Thunderbolt 5
- Pozor: pamäť sa nedá dokúpiť; v septembri bola čakacia lehota až 18 týždňov
Pre koho: modely 100–250B, agenti s dlhým kontextom, malé tímy. Pre koho nie: modely do 30B, CUDA, obmedzený rozpočet.
Na Alze: 96 GB od 6 699 €, 256 GB od 11 099 €.
6. Mac mini M5 Pro – rozumný vstup
Najlacnejší Mac, na ktorom už rozbehnete naozaj použiteľné modely. Priepustnosť 307 GB/s, až 64 GB pamäte a Thunderbolt 5. Vďaka neurálnym akcelerátorom číta prompt zhruba trikrát rýchlejšie ako predchádzajúci M4 Pro. Vo verzii so 64 GB pobežia modely do 32 miliárd parametrov pohodlne, hustá Llama 70B sa zmestí, ale pobeží len okolo 7 tokenov za sekundu, a gpt-oss-120b sa nezmestí.
- Pamäť: 24, 48 alebo 64 GB · priepustnosť 307 GB/s
- Spotreba: 6 W v pokoji, max. 145 W · v pokoji prakticky nepočuteľný
Pre koho: modely 20–35B, tichý domáci AI server. Pre koho nie: gpt-oss-120b, husté 70B, verzia s 24 GB.
Na Alze: 48 GB za 2 909 €, 64 GB za 3 129 €.
7. Mac mini M6 – lacno, ale nie so 16 GB
Najlacnejší Mac s neurálnymi akcelerátormi. Maximum je 32 GB a priepustnosť 170 GB/s – 16-gigabajtová verzia má len 153 GB/s a pre model zostane okolo 12 GB. Oproti predchádzajúcemu Macu mini s M4 číta prompt 4,5× rýchlejšie a píše o polovicu rýchlejšie za prakticky rovnakú cenu, takže starý model nekupujte ani v zľave.
- Pamäť: 16, 24 alebo 32 GB (maximum) · priepustnosť 153 / 170 GB/s
- Spotreba: 4 W v pokoji, max. 70 W
- Pozor: len Thunderbolt 4, takže bez prepájania viacerých kusov
Pre koho: modely 7–14B, gpt-oss-20b, Qwen3 30B-A3B. Pre koho nie: verzia so 16 GB, modely 70B a viac.
Na Alze: 24 GB za 1 299 €, 32 GB za 1 739 €.
8. MacBook Pro M5 Max – AI na cestách
Rovnaký čip ako Mac Studio, a teda aj rovnaká rýchlosť: najrýchlejší notebook na lokálne modely. So stredne veľkým modelom Qwen3.6 35B-A3B generuje cez 90 tokenov za sekundu. Štrnásťpalcová verzia sa však pod trvalou záťažou priškrcuje (príkon z 96 na 42 W) a nabíjanie je obmedzené na 97 W. Mac Studio s rovnakým čipom a 128 GB stojí takmer o 1 900 € menej.
- Pamäť: 36, 48, 64 alebo 128 GB · priepustnosť 460 / 614 GB/s
- Batéria: 72,4 Wh (14″) / 100 Wh (16″)
Pre koho: kto potrebuje veľké modely so sebou, ideálne šestnásťpalcový so 64–128 GB. Pre koho nie: verzia s 36 GB, trvalá prevádzka, kto pracuje za stolom.
Na Alze: 64 GB od 6 079 € (s americkou klávesnicou), 128 GB za 7 759 €.
9. RTX 5090 – najrýchlejšia, ale len 32 GB
Priepustnosť 1 792 GB/s: model gpt-oss-20b píše takmer 300 tokenov za sekundu a dlhý prompt karta číta zhruba dvakrát rýchlejšie ako Mac Studio s M5 Ultra. Do 32 GB sa zmestia modely do zhruba 32 miliárd parametrov v 4 bitoch aj s dlhým kontextom; sedemdesiatmiliardový model nie. Veľké MoE modely sa dajú čiastočne odložiť do bežnej RAM – gpt-oss-120b potom beží okolo 30 tokenov za sekundu.
- Pamäť: 32 GB GDDR7 · priepustnosť 1 792 GB/s
- Príkon: 575 W, odporúčaný zdroj 1 000 W
- Cena pri uvedení 1 999 dolárov, tento rok pre nedostatok pamätí výrazne vyššie
Pre koho: programovací agenti a RAG s modelmi do 32B, vývoj s CUDA, hry. Pre koho nie: modely 70B a viac, tichý úsporný server.
Na Alze: karta od 4 719 € (rozbalená), k dispozícii sú aj hotové PC s RTX 5090.
10. RTX 5060 Ti 16 GB – najlacnejší rozumný vstup
Najlacnejšia nová 16-gigabajtová grafika na Alze. Model gpt-oss-20b na nej píše okolo 92 tokenov za sekundu, Qwen3 8B 69 a Qwen3 14B 41 – rýchlejšie, ako stihnete čítať. Priepustnosť pamäte je však polovičná oproti RTX 5070 Ti, takže píše zhruba polovičným tempom, a modely okolo 30 miliárd parametrov sa do 16 GB nezmestia.
- Pamäť: 16 GB GDDR7 · priepustnosť 448 GB/s
- Príkon: 180 W, stačí zdroj 600 W
Pre koho: prvé vážne pokusy, modely 8–20B, lacné PC na AI. Pre koho nie: modely 27B a viac.
Na Alze: od 762,90 €.
11. RTX 5070 Ti vs. RTX 5080 – na AI takmer rovnaké
Obe karty majú 16 GB a takmer rovnakú priepustnosť (896 vs. 960 GB/s), a preto píšu takmer rovnako rýchlo: v štandardnom teste llama.cpp 182,4 vs. 184,7 tokenov za sekundu, pri modeli Qwen3 14B 74 vs. 81. Zmestia sa do nich presne rovnaké modely. Päťaosemdesiatka je rýchlejšia hlavne v hrách a stojí o zhruba 400 € viac.
Odporúčanie: na AI berte RTX 5070 Ti a ušetrené peniaze dajte do väčšieho disku alebo RAM. RTX 5080 kúpte len vtedy, keď na nej budete hlavne hrať.
Na Alze: RTX 5070 Ti od 1 259 €, RTX 5080 od 1 669 €.
12. RTX PRO 6000 – 96 GB v jednej karte
Jediná karta, do ktorej sa celá zmestí Llama 3.3 70B (32 tokenov za sekundu), gpt-oss-120b (170,6 tokenov za sekundu vo verzii Max-Q) aj Qwen3.5 122B (okolo 98 tokenov za sekundu). Vďaka CUDA a nástroju vLLM zvládne obslúžiť viac používateľov naraz. Alza ju predáva v hotových pracovných staniciach AlzaPC VisionBox PRO s procesorom Threadripper PRO – ako firemný tovar, ktorý sa nedá vrátiť.
- Pamäť: 96 GB GDDR7 s ECC · priepustnosť 1 792 GB/s
- Príkon: 300 W (Max-Q), plná verzia 600 W s asi o 13 % rýchlejším písaním
Pre koho: firmy a tímy, ktoré chcú prevádzkovať veľké modely interne alebo ich trénovať. Pre koho nie: jednotlivci a hobby.
Na Alza.sk sa VisionBox PRO nepredáva, dostupný je len na alza.cz: s jednou kartou za 642 900 Kč, lacnejšou alternatívou sú dve karty Radeon AI PRO (64 GB) za 364 900 Kč.
13. DGX Spark od ASUSu, MSI, Lenova, Dellu a Gigabyte – ktorý vybrať
Rovnaký čip GB10 ako DGX Spark predáva päť ďalších výrobcov. Výkon v AI sa líši len o pár percent, rozdiel je v disku, zdroji, chladení a servise – a v cene, ktorá sa na Alze líši až o takmer 3 000 €.
| Model | Disk | Zdroj | Špecialita |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB šifrovaný | 240 W | originál |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | najrýchlejší disk |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | tlačidlo vpredu |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB šifrovaný | 240 W | rok servisu na mieste |
| Dell Pro Max s GB10 | PCIe 4.0 (2 TB QLC) | 280 W | silnejší zdroj, najteplejší disk |
| MSI EdgeXpert | 4 TB | – | novinka bez nezávislých testov |
Odporúčanie: najlepšiu výbavu za rozumné peniaze má Gigabyte AI TOP ATOM so 4 TB rýchleho disku; najlacnejší vyskúšaný štart je ASUS Ascent GX10 s 1 TB. Kto plánuje prepojiť dva kusy, potrebuje kábel QSFP.
Na Alze: od 7 108,99 € (MSI EdgeXpert), Gigabyte AI TOP ATOM 4 TB za 7 299 €.
14. Radeon AI PRO R9700 – 32 GB za polovicu ceny RTX 5090
Najlacnejšia nová karta s 32 GB. V rovnakom teste cez Vulkan píše zhruba o 40 % pomalšie ako RTX 5090, ale zmestia sa do nej rovnaké modely – okolo 30 miliárd parametrov aj s dlhším kontextom. gpt-oss-20b a Qwen3 30B-A3B na nej bežia cez 150 tokenov za sekundu. Pozor na marketing: „až päťkrát rýchlejšia ako RTX 5080“ platí len pre model, ktorý sa do 16 GB nezmestí.
- Pamäť: 32 GB GDDR6 · priepustnosť ~640 GB/s · príkon 300 W
- Softvér: Vulkan (zvyčajne rýchlejšie píše) alebo ROCm (rýchlejšie číta prompt); bez CUDA
Pre koho: modely 27–32B s dlhým kontextom, viac kariet v jednom PC. Pre koho nie: nástroje len pre CUDA, maximálna rýchlosť.
Na Alze: 2 219 €.
15. „AI PC“ a Copilot+ notebooky – mýtus
Copilot+ je certifikácia Microsoftu pre funkcie Windows – efekty kamery, živé titulky, Recall alebo malý vstavaný model Phi Silica. Nehovorí nič o schopnosti prevádzkovať veľké jazykové modely. Ollama ani LM Studio neurálny procesor (NPU) nepoužívajú, llama.cpp len experimentálne; NPU využijú len nástroje výrobcov ako Microsoft Foundry Local alebo AMD Lemonade s vybranými modelmi.
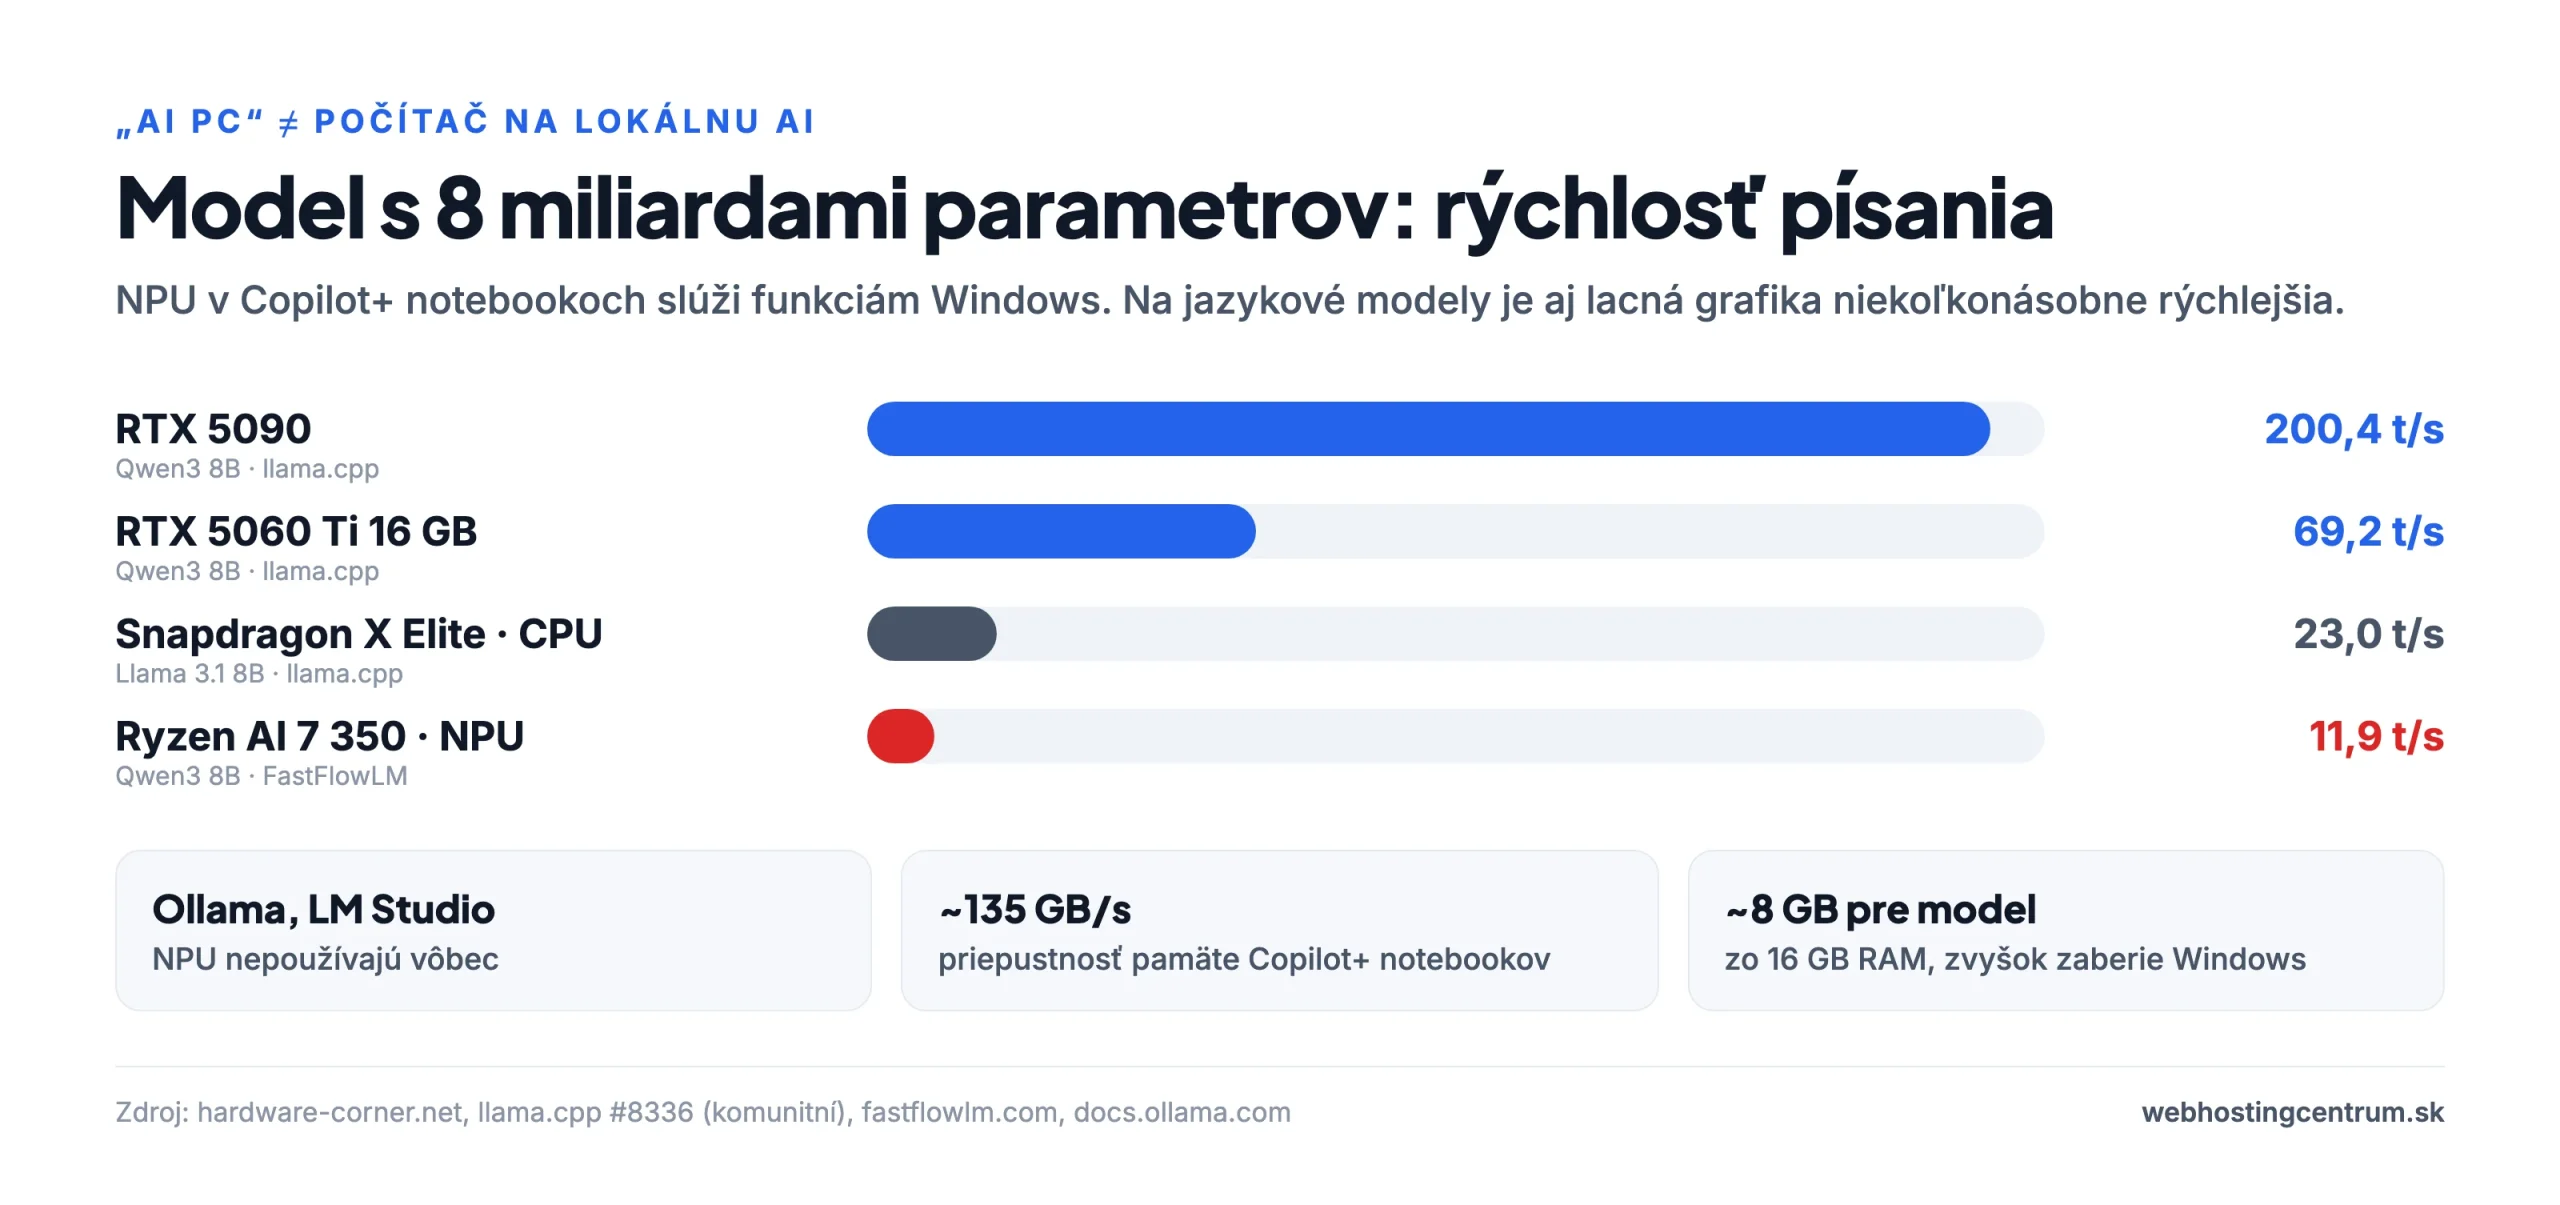
Navyše majú tieto notebooky pamäť s priepustnosťou okolo 135 GB/s a 16 GB RAM, z ktorých pre model zostane okolo 8 GB. Na modely do 4 miliárd parametrov a funkcie Windows sú fajn, na „vlastný ChatGPT doma“ nie.
Pre koho: kancelária, výdrž batérie, malé modely 1–4B. Pre koho nie: kto chce prevádzkovať modely 14B a väčšie.
Na Alze: Copilot+ notebooky od 899 €.
Spotreba a prevádzka
Ak má počítač bežať ako domáci AI server nonstop, záleží aj na spotrebe a hluku.
| Zariadenie | V pokoji | Pri behu modelu / maximum | Poznámka |
|---|---|---|---|
| Mac mini M6 | 4 W | max. 70 W | prakticky nepočuteľný |
| Mac mini M5 Pro | 6 W | max. 145 W | 5 dBA v pokoji (Apple) |
| Mac Studio M5 Max | 7 W | max. 200 W | tichý |
| Mac Studio M5 Ultra | 9 W | ~300 W pri AI | podľa recenzií tichý |
| DGX Spark | 25–45 W | 60–90 W pri AI, špičky do 200 W | podľa verzie firmvéru |
| Ryzen AI Max+ 395 mini PC | ~13 W | 120–160 W | HP Z2 Mini pod záťažou hlučný |
| RTX 5090 (len karta) | – | až 575 W | k tomu zvyšok PC |
| RTX 5060 Ti (len karta) | – | až 180 W |
Hodnoty pochádzajú od výrobcov a z recenzií (ServeTheHome, Tom’s Hardware, Notebookcheck) a nie sú merané rovnakou metódou – berte ich ako orientačné.
Softvér: čím model spustiť
- Ollama – najjednoduchší štart na všetkých platformách, model stiahnete jedným príkazom. Na Macu od verzie 0.19 (zatiaľ v ukážkovej verzii, pre vybrané modely) používa MLX a neurálne akcelerátory M5.
- LM Studio – prehľadná aplikácia s grafickým rozhraním. Tip pre Mac M5: pri modeloch GGUF zatiaľ nevyužíva neurálne akcelerátory a číta prompt zhruba polovičným tempom; použite modely vo formáte MLX.
- llama.cpp – základ väčšiny ostatných nástrojov, najviac nastavení a najrýchlejšia podpora nového hardvéru. Na Ryzene AI Max skúste oba backendy: Vulkan zvyčajne rýchlejšie píše, ROCm rýchlejšie číta dlhý prompt.
- MLX – knižnica Applu, najlepší výkon na Macu vrátane prepájania viacerých Macov cez Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM – serverové nástroje pre NVIDIA, keď model obsluhuje viac používateľov naraz.
Najčastejšie chyby pri nákupe
- Mac s 36 GB „na AI“. Má slabší čip a pre model zostane len okolo 27 GB.
- RTX Spark notebook s 32 GB. Windows dá grafike najviac 16 GB.
- Mac mini M6 so 16 GB. Pomalšia pamäť a pre model len okolo 12 GB.
- Copilot+ notebook kvôli lokálnej AI. NPU bežné programy nepoužívajú.
- RTX 5080 namiesto 5070 Ti len kvôli AI. Rovnakých 16 GB, rýchlosť takmer rovnaká.
- Ignorovať priepustnosť pamäte. Veľká pamäť s pomalou priepustnosťou znamená pomalé písanie pri hustých modeloch.
- Šetriť na pamäti. Pri Macoch, Ryzene AI Max aj RTX Spark je pamäť napevno a neskôr ju nedokúpite.
Časté otázky
Stačí na lokálnu AI 16 GB? Na modely do 14–20 miliárd parametrov áno, napríklad gpt-oss-20b alebo Qwen3 14B. Na modely okolo 30 miliárd potrebujete 24–32 GB, na 70 miliárd aspoň 48 GB.
Mac, alebo NVIDIA? Mac rýchlejšie píše a má viac pamäte za euro, NVIDIA rýchlejšie číta prompt a má CUDA. Na chat a agentov s MoE modelmi vychádza lepšie Mac, na vývoj, tréning a obsluhu viacerých používateľov NVIDIA.
Čo znamená „MoE“? Mixture of experts: model má veľa parametrov, ale pri každom slove počíta len malú časť. Potrebuje veľkú pamäť, ale píše rýchlosťou menšieho modelu.
Ako rýchlo musí model písať? Okolo 15 tokenov za sekundu zodpovedá rýchlosti čítania. Pre plynulý chat je príjemných 30 a viac, pre programovacích agentov, ktorí generujú veľa textu, sa hodí 50 a viac.
Oplatí sa lokálna AI oproti predplatnému? Finančne väčšinou nie – modely porovnateľné s najlepšími cloudovými službami vyžadujú stroje za tisíce až desaťtisíce eur. Hlavným dôvodom je súkromie, kontrola nad dátami a nezávislosť.
Môžem prepojiť viac počítačov? Áno. Dva DGX Sparky sa prepoja káblom QSFP, Macy s Thunderboltom 5 cez RDMA (nástroje MLX alebo exo). Pri Macoch mini M6 to pre Thunderbolt 4 nejde.
Ako sme porovnávali a zdroje
Zariadenia sme sami netestovali. Čísla pochádzajú z overených zdrojov a v grafoch ich vždy uvádzame. Rýchlosť porovnávame v jednom programe (llama.cpp), pretože iný program alebo kvantizácia dajú výsledky pokojne o 20–50 % iné. Komunitné merania (GitHub, fóra) označujeme. Ceny sme overili na Alza.sk v októbri 2026.
- Výpadok modelu do RAM, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- DGX Spark benchmark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- Sprievodca gpt-oss a merania grafík: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max a LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16. 10. 2026), servethehome.com, storagereview.com
- Grafické karty GeForce: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- Rebríčky llama.cpp: github.com/ggml-org/llama.cpp/discussions/15013 a /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Veľkosti modelov: huggingface.co (repozitáre ggml-org, unsloth, bartowski)